
반응형
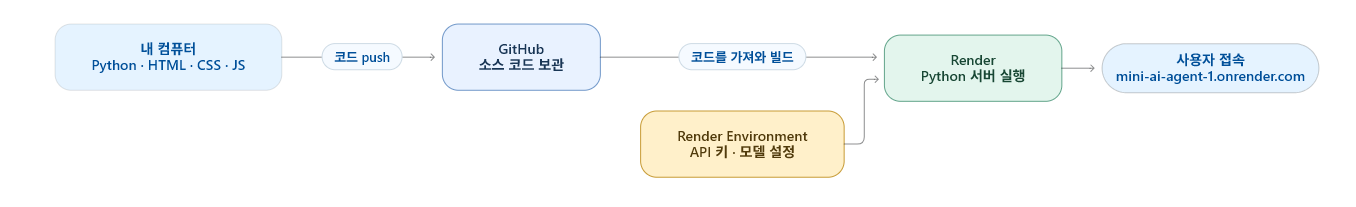
GitHub는 코드 보관소, Render는 실제 실행 장소야. 프론트 화면과 Python API를 같은 서버에서 제공해.
저장소의 배포 설정은 pip install .로 설치하고, python -m mini_ai_agent.server --host 0.0.0.0으로 실행하도록 되어 있어.
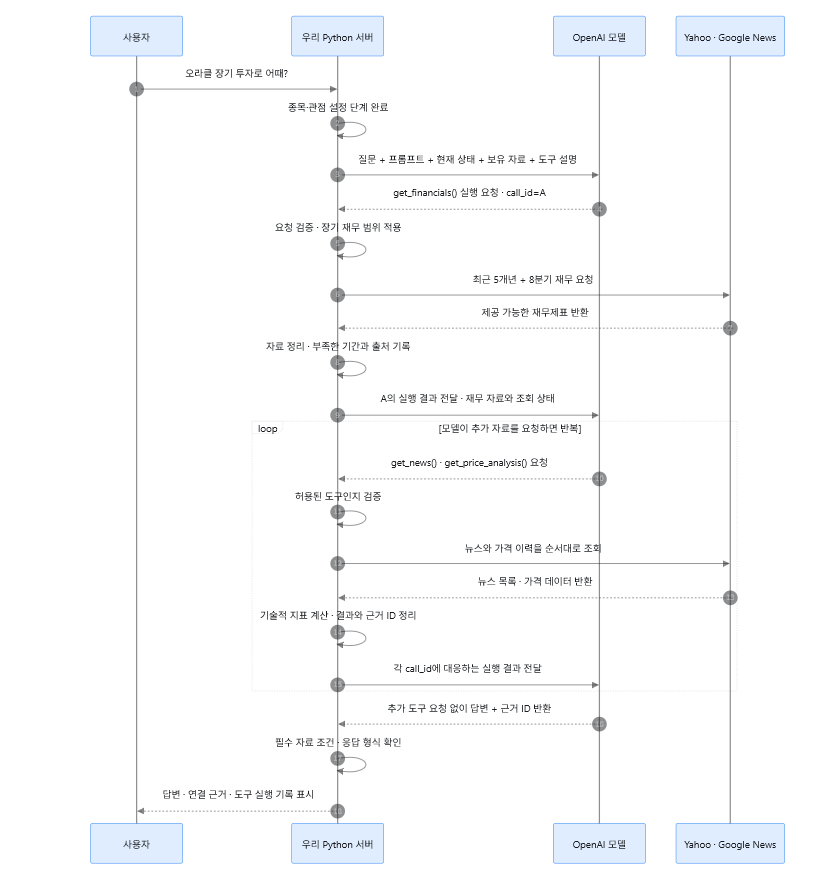
flow
eval
.\.venv\Scripts\python.exe evals/run.py --live --case clarify_then_reuse.\.venv\Scripts\python.exe evals/run.py --live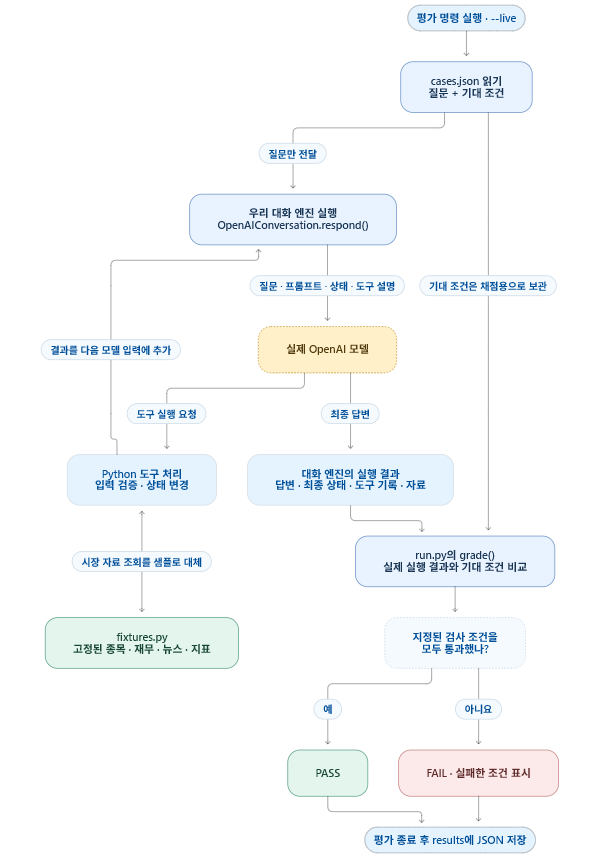
응. 지금 만든 건 오프라인 평가야. 여기서 ‘오프라인’은 인터넷을 안 쓴다는 뜻이 아니라, 실제 서비스 운영과 분리해서 미리 준비한 문제로 평가한다는 뜻이야.
| 구분 | 오프라인 평가 | 온라인 평가 |
| 평가 대상 | 미리 준비한 질문·시나리오 | 실제 사용자들의 서비스 이용 |
| 예시 | cases.json을 실행해서 PASS/FAIL 확인 | 실제 답변의 만족도, 오류율, 응답 시간 관찰 |
| 우리 프로젝트 | 현재 구현된 방식 | 아직 별도 평가 체계 없음 |
헷갈리기 쉬운 부분은 --live도 오프라인 평가라는 거야.
- --live: 실제 OpenAI 모델을 호출한다는 실행 옵션. 인터넷 연결과 API 비용이 필요해.
- 오프라인 평가: 준비된 테스트셋으로 서비스와 분리해 평가한다는 평가 방식.
즉, 우리는 “실제 모델 + 고정 샘플 자료 + 미리 정한 시나리오”로 오프라인 평가를 하고 있어.
반응형
'LLM for Prompt Engineering' 카테고리의 다른 글
| 11장. 미래를 전망하며 (0) | 2026.10.12 |
|---|---|
| 10. LLM 애플리케이션 평가 (0) | 2026.10.12 |
| 제 9장. LLM 워크플로 (0) | 2026.10.06 |
| 제 8장. 대화형 에이전시 (0) | 2026.10.03 |
| 제 7장. 모델 제어 (0) | 2026.10.03 |