이 글을 읽는다고 세종대왕처럼 큰일을 해낼 수 있는 건 아니지만, 적어도 그의 시선으로 세상을 다시 한번 바라볼 수 있을 것 같습니다.
Chapter. 01. 왜 사람부터 볼 줄 알아야 하는가
001. 알게 하는 것과 통제하려는 것을 구분해라
세종대왕은 자신이 가진 직위와 힘을 이용해 백성을 다스리려고 하기보다는 백성이 스스로 깨닫기를 원했다.
경험으로 보건대, 허조처럼 상대에게 설명하기보다 눈치껏 하기를 바라는 사람은 자신의 권위가 밀리는 것을 두려워하거나, 타인을 도구로 대하는 사람이 대부분이었다. 반대로 세종대왕처럼 다정히 설명하고 그 이유를 말해주는 사람은 그 사람이 정말 잘 되고, 오랫동안 함께하길 바라는 마음을 가진 사람이 대부분이었다.
다그침은 복종을 만들고, 설명은 판단력을 만든다.
002. 문제를 말하는 사람과 문제를 해결하는 사람을 구분해라
현실의 고통을 지적하는 것은 누구나 할 수 있다. 무엇이 잘못됐는지, 어디에 문제가 있는지 불만을 늘어놓는 것은 어렵지 않다. 그래서 많은 이들이 불평불만을 쉽게 한다. 그런데 이런 불만을 토로하는 이들 중 대다수는 ‘해결책’을 말하라고 하면 아무 말도 하지 못한다.
그래서 우리는 부정적인 것들을 논리적으로 말하는 사람을 믿기보다, 그 해결책을 건네는 사람을 따라야 하고 또 그런 사람이 되어야 한다.
차라리 문제점만 지적하며 가만히 있는 편이 덜 웃음거리가 될 수도 있다. 그러나 세종이 바라보는 시각처럼, 진짜로 성장하는 사람은 그런 것에 머물지 않는다.
GitHub Copilot 팀은 프롬프트나 UI보다 평가 코드를 먼저 작성했어. 이를 통해 변경 사항이 성능 개선인지, 악화인지, 별다른 영향이 없는지 확인하면서 빠르게 개발할 수 있었어.
적절한 평가방식은 상황에 따라 달라진다.
- 애플리케이션이 무엇인지
- 애플리케이션 생애 주기상에서 프로젝트가 어디에 위치하는지 등등
크게 온라인, 오프라인 평가로 나뉜다.
1. 오프라인 평가 - 실제 운영중인 애플리케이션과 독립적인 예제 사례로 평가
-> 하지만 실제와 동떨어진 이론이다.
2. 온라인 평가 - 실제 테스트 해볼 수 있기에 오프라인 평가에 비해 위험요소도 크다.
-> UX는 잘되어 있어야한다. 유의미한 사용자 수도 확보해야 피드백이 정확하다.
10.1 LLM 애플리케이션 평가
평가는 다음 3가지 측면에서 진단한다.
1. 사용하는 모델 자체
2. 모델과의 개별 상호작용(즉, 프롬프트)
3. 이러한 여러 상호작용이 전체 애플리케이션 속에서 어떻게 조화를 이루는지.
-> 전체 상호작용 테스트(회귀 테스트), 구성단위를 테스트(단위 테스트)
변경하려는 대상
적합한 테스트
이유
모델 교체·업그레이드
전체 흐름을 폭넓게 확인하는 회귀 테스트
모델 변경이 앱 전반에 미치는 영향을 확인해야 함
프롬프트·온도 등 API 매개변수
개별 호출을 확인하는 단위 테스트
변경이 직접 영향을 주는 단계의 효과를 확인하기 좋음
앱 아키텍처·반복 구조
전체 흐름을 확인하는 회귀 테스트
구조 변경에 따른 최종 결과를 비교해야 함
처음에는 전체 실행 루프를 최대한 포함하는 테스트를 만들고, 이후 어렵거나 중요한 상호작용에 단위 테스트를 추가하면 된다. 최종 목표는 전체 시스템의 성능을 높이는 것이기 때문
10.2 오프라인 평가
오프라인 평가 모음은 복잡도의 범위가 매우 광범위.
10.2.1 예제 모음
예제 스위트는 여러 입력 예시를 모아, 프롬프트를 바꿀 때마다 결과를 비교하는 구성. 다음 세 가지로 이루어짐.
입력 예시 5~20개: 실제로 발생할 만한 다양한 상황을 준비해.
실행 스크립트: 각 예시에 대해 프롬프트를 생성하고 모델을 호출한 뒤, 프롬프트와 답변을 파일로 저장해.
결과 비교 방법: git diff 같은 도구로 변경 전후의 차이를 사람이 확인해.
다만 사람이 매번 읽을 수 있는 예제 수에는 한계가 있어. 미묘한 성능 차이를 확인하려면 수백~수천 개의 예제가 필요할 수 있으므로, 평가 규모를 키우려면 두 가지를 해결해야 해.
예제를 어디서 충분히 확보할 것인가?
결과의 품질을 어떻게 자동으로 평가할 것인가?
여러 차례 대화하는 앱에서는 앞선 답변이 다음 단계에 영향을 주기 때문에, 다음 두 방식으로 평가할 수 있어.
방식
진행 방법
장점과 한계
미리 작성된 대화로 단계별 평가
각 단계의 모델 답변을 평가하되, 다음 단계에는 실제 생성 답변 대신 대본에 정해진 답변을 넣어 진행
동일한 대화 맥락에서 각 단계를 비교할 수 있지만, 실제 답변이 누적되는 전체 흐름은 확인하기 어려움
LLM으로 사용자 시뮬레이션
사용자 역할의 모델에 프로필·지시를 주고, 앱의 실제 답변에 반응하게 함
전체 대화 흐름을 테스트할 수 있지만, 사용자 역할 모델의 오해나 편견이 평가에 영향을 줄 수 있음
10.2.2 샘플 찾기
**“평가용 샘플은 기존 자료, 실제 사용 기록, 직접 생성한 데이터에서 확보할 수 있으며, 각각의 현실성과 편향을 고려해야 한다”**는 거야.
샘플 출처
장점
한계·주의점
기존 자료
이미 있는 데이터를 활용해 많은 샘플을 확보할 수 있음
실제 앱이 해결하는 문제와 완전히 같지 않을 수 있음
앱의 실제 사용 기록
실제 사용 상황을 가장 잘 반영함
프로토타입 출시 후부터 수집 가능하고, 앱이 크게 바뀌면 과거 데이터의 유효성이 떨어질 수 있음
LLM으로 생성한 데이터
다양한 상황의 샘플을 대량으로 만들 수 있음
부정확하거나 비현실적인 예제, 모델의 편향이 포함될 수 있음
기존 자료를 활용할 때는 ‘충분한 양’과 ‘실제 문제와의 유사성’ 사이의 균형이 중요해.
Copilot은 사용자가 다음에 입력하려는 코드에 대한 데이터가 부족했기 때문에, 기존 코드를 변형해서 평가 문제를 만들었어.
오픈 소스 코드에서 함수를 선택해.
함수 본문을 지워, 사용자가 구현을 앞둔 상황을 만들어.
Copilot이 빈 부분을 완성하도록 해.
실제 자동완성보다 작성할 코드가 길고, 필요한 import가 이미 들어 있는 등 현실과 차이는 있었어. 하지만 방대한 평가 샘플을 확보할 수 있다는 장점이 있었지.
실제 사용 기록에서는 ‘좋은 입력’과 ‘믿을 만한 정답’을 구분해야 해. 사용자의 질문은 좋은 평가 문제가 되지만, 사용자의 최종 행동은 앱의 제안에 영향을 받았을 수 있으므로 정답으로 단정할 수 없어. 또한 기록 수집에는 사용자 동의와 데이터 보호가 필요해. 기준 정답 없이 평가할 수 있는 방식에서는 이러한 입력 기록을 유용하게 활용할 수 있어.
LLM으로 샘플을 생성할 때는 주제를 먼저 나누고, 그 안에서 예제를 만드는 계층적 접근이 좋아.
주제·조건 구성: 여러 측면의 선택지를 조합해서 다양한 상황을 만들어. 선택지가 각각 \(n, m, l, k\)개라면 \(n \times m \times l \times k\)개의 조합이 가능해.
주제별 샘플 생성: 각 주제에서 여러 예제를 생성해. 책에서는 같은 요청을 반복하는 것보다, 한 번에 여러 예제를 요청하는 편이 더 다양한 결과를 얻을 수 있다고 설명해.
해결책에서 역으로 생성: 가능한 경우에는 먼저 해결책을 정하고, 그 해결책에 대응하는 문제를 만들 수도 있어.
특히 평가받는 모델과 샘플을 만드는 모델이 같으면 평가가 편향될 수 있어. 모델 A가 만든 샘플만으로 A와 B를 비교하면, A에 유리한 평가가 될 가능성이 있다는 거야.
10.2.3 답안 평가
핵심은 **“생성된 답변의 품질은 기준 정답과의 비교, 실제 기능 검증, LLM의 판단이라는 세 가지 방식으로 평가할 수 있다”**는 거야.
평가 방법
확인하는 것
대표 사례
기준 정답과 비교
정해 둔 답과 얼마나 일치하는가?
예/아니오 판단, 분류 결과 비교
기능 테스트
결과가 요구된 기능을 수행하는가?
생성한 코드의 단위 테스트 실행
LLM 평가
자연어 답변의 품질이 어떤가?
친절함·유용성 등 평가
기준 정답인 ‘골드 스탠다드’와 비교할 때는 완전 일치와 부분 일치를 구분해야 해.
완전 일치: 출력이 기준 정답과 정확히 같은지 확인해. 예/아니오나 분류처럼 답의 형태가 제한적일 때 유용해.
부분 일치: 중요한 요소만 골라 비교해. 코드의 주석·형식 차이를 제외하거나, 여행 추천에서 목적지 국가만 비교하는 방식이야.
자유로운 문장이나 긴 답변은 내용이 올바르더라도 표현이 다를 수 있으므로, 완전 일치만 평가하면 실제 품질보다 특정 표현을 재현하는 능력을 측정하게 될 수 있어.
책의 난방 사례에서도 정확히 77°F를 출력했는지만 보기보다, 온도 조절 도구를 선택하고 올바른 형식으로 호출했는지를 확인하는 데 초점을 맞춰. 다만 부분 일치는 검사하지 않은 요소의 오류를 놓칠 수 있어.
따라서 평가 항목은 다음 조건을 만족해야 해.
실제 오류와 허용할 만한 차이를 구분할 수 있어야 함.
너무 구체적이어서 정상적인 답을 탈락시키거나, 너무 포괄적이어서 잘못된 답을 통과시키지 않아야 함.
특히 도구 사용 여부 → 도구 선택 → 인수 설정처럼 결정이 이어질 때는, 뒤의 판단까지 무효로 만들 수 있는 앞단의 중요한 결정부터 평가하는 것이 유용해. 현재 모델이 잘하는 부분에 맞춰 평가 기준을 정하면 이후 개발 방향도 편향될 수 있다는 점은 주의해야 해.
기능 테스트는 기준 답안과 모양이 같은지보다, 결과가 실제로 작동하는지 확인하는 방식이야.
Copilot 사례에서는 생성한 코드로 기존 함수 본문을 교체한 뒤, 저장소의 단위 테스트가 여전히 통과하는지 확인했어. 그 외에도 출력의 파싱 가능 여부, 존재하는 도구만 호출하는지, 인수의 자료형이 맞는지 등을 검사할 수 있어. 다만 이런 검사만으로 답변의 전체 품질을 판단하기 어려운 경우도 많아.
LLM 평가는 친절함이나 유용성처럼 규칙으로 정의하기 어려운 품질을 평가할 때 활용해. 여기에는 두 가지 중요한 주의점이 있어.
평가 점수를 실제 정확도와 동일시하지 않기: 평가 LLM이 답변의 81%를 옳다고 판단했다고 해서 실제 정답률이 81%라는 뜻은 아니야. 책은 이런 평가를 동일한 기준에서 버전 A와 B를 비교하는 상대적 판단으로 해석하라고 강조해.
자기 답변을 채점하는 상황 피하기: 모델이 자기 답변이라고 인식하면 기존 답을 옹호하거나, 반대로 사용자의 의심에 맞춰 판단을 바꾸는 편향이 생길 수 있어. 따라서 제3자의 답변을 평가하는 형태로 제시하는 것이 중요하다고 설명해.
10.2.4 SOMA 평가
핵심은 **“LLM에게 막연히 ‘좋은 답인가?’라고 묻지 말고, 평가 질문·점수 기준·평가 측면을 구체적으로 정하라”**는 거야. 이를 위한 방식이 SOMA 평가야.
구성 의미
적용
예시
S: 구체적인 질문
무엇을 판단할지 명확하게 질문
“이 행동이 사용자의 추위 문제를 해결하는가?”
O: 서수 척도 응답
의미가 정의된 단계별 점수로 평가
1~5점으로 평가하되 각 점수의 기준을 설명
MA: 다각적인 평가
품질을 여러 측면으로 나누어 각각 평가
문제 해결 효과, 도구 호출의 정확성, 개입의 적절성
구체적인 질문은 평가할 대상을 좁혀 줘. “이 답변이 맞는가?”라고만 물으면 모델이 어떤 때는 온도를, 어떤 때는 도구 선택을, 어떤 때는 사용자 허락 여부를 평가할 수 있어. 평가 항목을 명시해야 매번 같은 관점으로 비교하기 쉬워져.
서수 척도는 단순한 예/아니오보다 정도의 차이를 표현할 수 있어. 다만 “1~5점으로 평가해”만으로는 부족하고, 각 점수의 의미를 정해야 해. 책의 효과성 평가 기준은 다음과 같아.
점수
의미
1점
문제 해결에 도움이 없거나 상황을 악화시킬 수 있음
2점
문제의 일부만 해결할 수 있음
3점
문제의 상당 부분을 해결할 가능성이 높음
4점
완전한 해결을 보장하지는 못하지만 대부분 해결할 가능성이 높음
5점
문제를 완전히 해결할 것으로 판단됨
평가 측면을 나눌 때는 ‘의도’와 ‘실행’을 구분하는 것이 유용해.
의도: 선택한 행동이 사용자의 문제에 적합한 해결책인가?
실행: 그 행동을 올바른 도구와 호출 형식으로 구현했는가?
일반적인 답변에서는 **관련성·진실성·완전성(RTC)**으로 나눌 수도 있어. 각각 질문에 맞는 내용인지, 사실이 정확한지, 필요한 내용을 빠짐없이 제공했는지를 평가하는 거야.
또한 “딱 적당한가?”처럼 두 판단이 섞인 질문은 분리해야 해. 예를 들어 “도움이 충분했는가?”와 “불필요하게 개입하지 않았는가?”를 따로 물으면 더 명확해져.
평가 프롬프트에서는 평가 목적과 질문, 점수별 기준을 먼저 제시하고, 그다음 평가할 답변을 제공하라고 권장해.
하지만 SOMA 형식을 갖췄다고 평가의 타당성이 보장되지는 않아. 실제로 잘 평가하는지는 사람의 판단과 비교해야 해.
여러 사람이 동일한 사례를 평가해.
사람들 사이에서도 어느 정도 의견이 갈리는지 확인해.
평가 LLM을 포함했을 때 불일치가 크게 늘어나는지 확인해.
즉, 한 사람의 점수와 완전히 일치하는지를 보기보다 사람들 사이의 의견 차이를 고려해도 LLM의 평가를 받아들일 만한지 확인하는 거야.
본문 마지막에서는 오프라인 평가를 구성할 때 다음 조건을 확인하라고 정리해.
선택 대상
방법
확인할 조건
입력 샘플
기존 기록
충분한 양을 확보할 수 있는가?
입력 샘플
앱 사용 기록
앱 변경으로 데이터가 낡는 속도를 고려해도 충분히 수집되는가?
입력 샘플
합성 예제
생성 절차를 설계하는 데 시간을 투자할 수 있는가?
출력 평가
기준 정답과 비교
완전·부분 일치가 현실적이고 의미 있는가?
출력 평가
기능 테스트
핵심 기능을 자동으로 검사할 수 있는가?
출력 평가
LLM 평가
사람이 좋은 결과와 나쁜 결과를 명확히 구분할 수 있는가?
10.3 온라인 평가
10.3.1 A/B 테스트
A/B 테스트는 실제 사용자를 나누어 기존 버전과 수정 버전을 비교하는 온라인 평가야. 중요한 것은 실험 전에 “어떤 지표가 좋아지면 개선이라고 볼 것인가?”를 정하는 것이야.
진행 과정은 다음과 같아.
오프라인 평가로 후보 선별: 효과가 없거나 사용자 경험을 크게 해칠 가능성이 있는 변경안을 미리 걸러.
지표 설정: 높이고 싶은 지표뿐 아니라, 악화되면 안 되는 지표도 정해. 예를 들어 수락률은 높이되 오류·불만은 늘어나지 않아야 해.
무작위로 그룹 배정: 일부 사용자에게 A, 나머지에게 B를 제공해. 앱은 실험 플래그에 따라 두 가지 로직을 실행할 수 있어야 해.
일정 기간 결과 수집·비교: 미리 정한 지표를 기준으로 어떤 버전이 더 좋은지 판단해.
효과가 확인된 버전 적용: 더 나은 대안을 전체 사용자에게 배포해.
온라인 평가는 사용자 수가 제한적이고 피드백 수집과 배포에도 시간이 걸리므로, 오프라인 평가보다 시도할 아이디어를 신중하게 선택해야 해.
10.3.2 평가 지표
평가에 사용할 지표는 크게 다섯 가지야.
지표
무엇을 확인하나?
예시
해석할 때의 주의점
직접 피드백
사용자가 결과를 어떻게 평가하는가?
좋아요·싫어요, 평점, 두 답변 중 선호 선택
반복적인 평가 요청은 사용자에게 부담이 됨
기능적 정확성
시도한 작업이 정상적으로 수행됐는가?
코드 컴파일, 프로그램 실행, 이메일 전송 성공
실행 성공만으로 내용이나 의도가 올바르다는 보장은 없음
사용자 수용도
사용자가 제안을 받아들였는가?
코드 제안 수락, 추천 링크 클릭
관심이나 첫인상을 보여 줄 뿐, 실제 유용성을 보장하지 않음
성과·영향도
제안이 최종 결과에 얼마나 반영됐는가?
최종 이메일에 남은 AI 작성 내용, 추천 클릭 후 실제 구매
최종 결과를 관찰할 수 있어야 하고, 수집에 시간이 걸릴 수 있음
부수적 지표
품질과 관련된 주변 신호가 어떻게 변했는가?
응답 지연 시간, 대화 길이
수치가 높거나 낮다는 이유만으로 좋고 나쁨을 단정하기 어려움
**수용도와 영향도의 차이는 ‘받아들였는가’와 ‘최종 결과에 이어졌는가’**야. 추천 링크를 클릭한 것과, 실제로 구매까지 이어진 것은 다른 수준의 신호인 거지.
직접 피드백도 받는 시점에 따라 가치가 달라져. 여행 추천을 받은 직후의 만족도보다 여행을 다녀온 뒤의 평가가 실제 도움을 판단하는 데 더 유용할 수 있어. 이렇게 수집한 피드백은 평가뿐 아니라 모델의 학습 데이터로도 활용할 수 있어.
부수적 지표는 특히 해석에 주의해야 해. 대화가 짧아진 이유가 빠른 문제 해결일 수도 있고, 사용자가 실망해서 떠난 것일 수도 있어. 따라서 단독으로 성공을 판단하기보다 다른 지표와 함께 보고, 예상치 못한 변화의 원인을 조사하는 데 활용해.
책에서는 우선 수용도·영향도 지표를 검토하고, 이것만으로 품질을 판단하기 어렵다면 직접 피드백을 요청하라고 권장해. 이와 함께 기능적 정확성, 지연 시간, 오류도 수집해서 다른 부분이 악화되지 않는지 확인하는 거야.
10.4 요약
앱마다 적합한 평가 방식은 다르지만, 지속적인 개선을 위해 평가는 필수적
샘플 출처, 결과 검증 방법, 사용자 반응 지표를 앱의 특성에 맞게 선택해야 해. 평가 체계에 투자한 시간은 이후의 변경이 실제 개선인지 판단할 수 있게 해 준다는 점에서 가치가 있어.
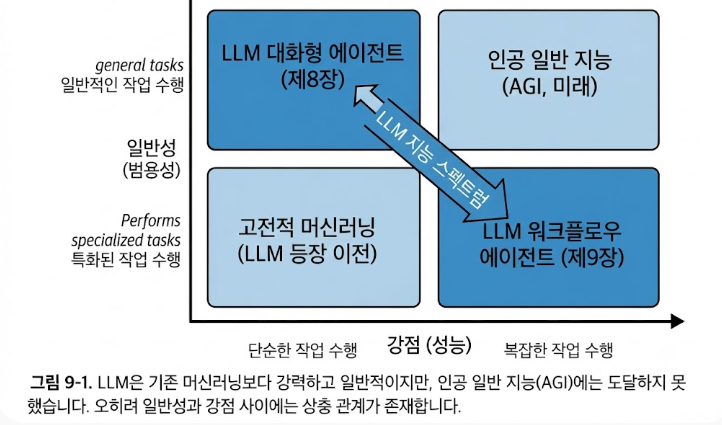
범용성을 다소 희생하는 대신, 특정 도메인에 집중하여 더 복잡한 작업을 높은 정확도로 수행하기 위해 LLM 워크플로우를 도입합니다.
큰 작업을 작고 명확하게 정의된 세부 작업들로 분해하고, 관리자 프로세스가 이를 조정 및 분배하여 원하는 결과를 도출합니다.
9.1 대화형 에이전트로 충분할까 ?
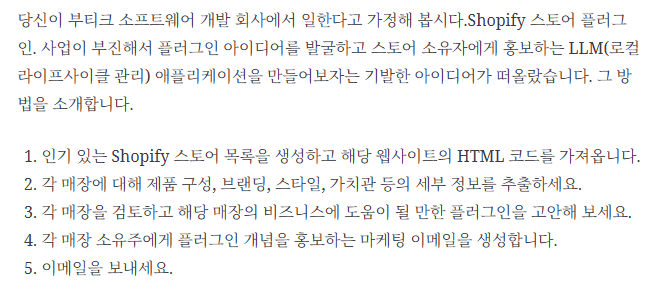
이렇게 각각 모든 쇼피파이를 사용하는 온라인 매장을 가져와서, 각각 맞는 니즈를 파악해서 메일로 다시 제안한다 ?
LLM 이라면 가능하다. 어떻게 대화형 에이전트만으로 수행이 되는걸까?
"여러 쇼피파이 온라인 매장을 수집하고, 각 매장에 어울릴 새로운 플러그인 아이디어를 생각한 뒤 각 매장 운영자에게 마케팅 이메일을 보내줘" -> 이건 말도안된다. 별로 도움이 되지 않는다.
하지만, 더 나은 결과를 얻는 것을 돕기 위해 에이전트에 도구를 제공하면 된다.
search_web, browse_site, send_email 같은 ..
9.2 기본 LLM 워크플로
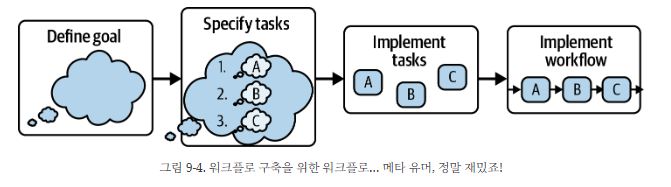
목표 정의하기
워크플로의 목적과 최종적으로 달성하고자 하는 결과물 또는 변화를 명확히 파악합니다.
작업 구체화하기
워크플로를 일련의 작업으로 나누고 순서대로 실행되도록 설계합니다.
LLM 기반 작업의 경우 필요한 도구, 입력 및 출력을 파악합니다.
작업 구현하기
입력과 출력이 명확히 정의되도록 작업을 구성합니다.
각 작업이 독립적으로 올바르게 작동하는지 확인합니다.
워크플로 구현하기
작업들을 서로 연결하여 완전한 워크플로를 구성합니다.
전체적인 맥락에서 원활하게 작동하는지 조율합니다.
워크플로 최적화하기
품질, 성능, 비용을 개선하기 위해 작업을 지속적으로 최적화합니다.
9.2.1 작업
두번쨰 작업은, 명세화 하는 것이다.
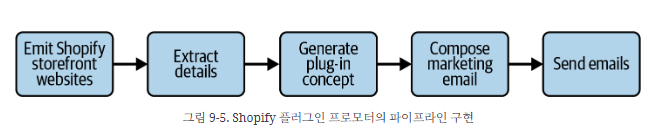
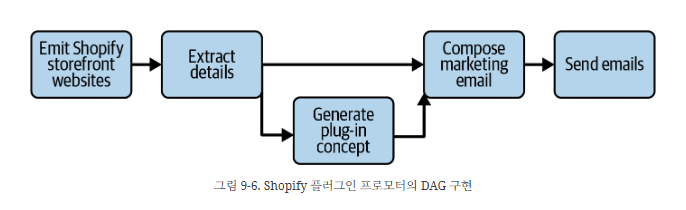
Shopify 플러그인 프로모터 예시에서 워크플로우를 구성하는 5가지 하위 작업은 다음과 같습니다.
인기 있는 Shopify 스토어 목록 생성 및 웹사이트 HTML 코드 가져오기
각 매장의 제품 구성, 브랜딩, 스타일, 가치관 등 세부 정보 추출
각 매장을 검토하여 비즈니스에 도움이 될 만한 플러그인 고안
각 매장 소유주에게 플러그인 개념을 홍보하는 마케팅 이메일 생성
이메일 전송
세번째 작업을 구현하는 단계로 넘어가서.
전반적인 목표의 하위 단계를 말한다.
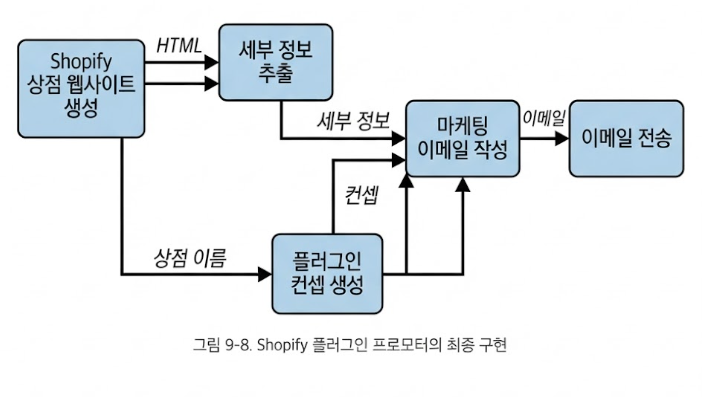
작업들이 서로 연결되어 매끄럽게 실행되려면 명확한 데이터 구조(스키마)가 정의되어야 합니다.
LLM을 활용한 작업 구현 방식은 크게 두 가지다.
프롬프트 템플릿: 입력 정보를 템플릿에 넣고, 작업에 맞는 결과를 생성한다. 여러 번 실행해 결과를 살펴보며 지침과 맥락을 다듬는다. 생성 결과에서 필요한 부분만 추출해 다음 단계로 전달한다.(랭체인이 권장하는 접근법)
도구 호출: HTML 같은 자유 형식 자료에서 이름·주소·전화번호처럼 구조화된 정보를 뽑을 때, 원하는 데이터 형식에 맞는 도구를 정의해 모델이 그 형식으로 결과를 반환하게 한다. 결과 구조가 복잡하면 작은 단위로 나눠 추출한다.
* 작업을 정교하게 다듬기 *
첫 프롬프트의 결과가 기대에 못 미치면 먼저 요구사항을 사람이 읽어도 분명하게 이해할 수 있도록 다듬는다. 그래도 문제가 남으면 다음 방법을 적용할 수 있다.
단계별 추론 유도: 모델이 도구를 부르기 전에 먼저 계획하고 생각하게 한다. OpenAI API에서는 도구 사양은 제공하되 tool_choice: "none"으로 당장 도구를 호출하지 못하게 할 수 있다.
자기 교정(Reflexion): 결과를 형식 검사, 코드 실행·테스트, LLM 검토 등으로 평가한다. 실패하면 오류 보고서와 이전 시도를 프롬프트에 넣어 다시 생성한다. 품질은 높일 수 있지만 비용과 시간이 늘어난다.
에이전트 협업: 개방형·복잡한 문제는 도구를 갖춘 전문가 에이전트와 이를 안내하는 사용자 프록시 에이전트가 협력하게 할 수 있다. AutoGen이 이런 구조를 지원한다.
모든 작업에 LLM을 쓸 필요는 없다.
웹 페이지 수집이나 데이터 저장처럼 규칙적인 작업은 크롤러·일반 코드로 처리한다.
분류처럼 가벼운 작업은 BERT 같은 전통적 머신러닝 모델이 더 빠르고 저렴할 수 있다.
비용이 크거나 되돌리기 어려운 작업, 사람의 판단이 필요한 작업에는 사람의 승인·검토 단계를 둔다.
LLM이 필요한 경우에도 간단한 작업은 저렴한 모델로, 어려운 작업은 성능 높은 모델로 나눠 맡긴다.
핵심: 작업마다 가장 적합한 방식을 고르고, 결과 검증과 사람의 감독을 워크플로에 포함하면 품질과 안전성을 높일 수 있다.
9.2.2 워크플로 구성하기
이제 워크플로우를 한개로 조립하면된다. 여러 방법들이 있다.
파이프라인 (Pipeline):
작업들이 순차적으로 연결되어 각 작업의 출력이 최대 하나의 작업에만 입력으로 사용되는 가장 단순한 구조입니다.
장단점: 단순하지만 유연성이 떨어져, 특정 정보를 여러 곳에서 재사용하기 어렵습니다.
방향성 비순환 그래프 (DAG, Directed Acyclic Graph):
하나의 작업이 여러 하위 작업으로 출력을 보내거나 여러 상위 작업의 입력을 받을 수 있는 구조입니다.
상위 종속 작업이 모두 성공해야만 다음 작업이 실행되며, Airflow나 Luigi 같은 널리 쓰이는 자동화 플랫폼에서 활용됩니다.
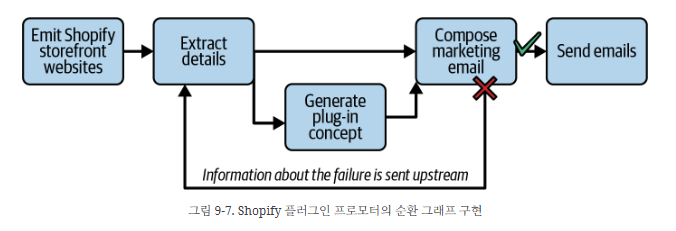
순환 그래프 (Cyclic Graph):
출력된 정보가 상위 작업으로 되돌아가 루프(Loop)를 형성하는 네트워크입니다.
LLM의 오류를 수정하기 위한 품질 관리(품질이 부족할 경우 상위 단계로 되돌려 보내는 등)에 유용할 수 있습니다.
주의점: 복잡성이 크게 증가하며, 오류 정보 재결합 처리, 실패 정보 처리, 무한 순환 방지(시도 횟수 제한) 등의 복잡한 예외 처리가 필요합니다. 가급적 재귀 호출은 작업 내부에 숨기는 것이 좋습니다.
* 그 외 *
일괄 워크플로 (Batch Workflow): 알려져 있고 유한한 작업 항목 집합을 처리하며, 설정 및 유지 관리가 간단하고 대용량 데이터 처리에 유리합니다.
스트리밍 워크플로 (Streaming Workflow): 프로세스 도중 생성되거나 검색되는 임의의 작업 항목을 처리하며, 실시간 저지연 작업에 적합하지만 상대적으로 더 복잡합니다.
워크플로 최적화
워크플로를 만든 뒤에는 단순히 프롬프트를 고치는 데 그치지 말고,
작업 자체가 목표에 맞는지 먼저 점검해야 한다.
작업 결과를 평가해 개선점을 제시하는 작업 단계의 피드백을 넣거나, 실패한 항목을 워크플로 앞단으로 돌려보내는 전체 흐름의 피드백을 설계할 수도 있다.
또한 각 작업의 입력과 출력 예시를 모아 오프라인 테스트를 만들면, 프롬프트를 바꿀 때 결과가 나빠지는지 배포 전에 확인할 수 있다. DSPy와 TextGrad는 이런 예시와 평가 기준을 이용해 프롬프트를 자동으로 최적화하는 프레임워크다.
운영을 시작한 뒤에는 실제 입력·출력 데이터를 기록하고 샘플링해 품질을 살핀다. 실제 트래픽에서 A/B 테스트를 진행하면 서로 다른 구현 방식을 비교할 수 있다.
핵심: 작업 설계, 피드백, 오프라인 테스트, 운영 데이터와 A/B 테스트를 반복해 워크플로의 품질을 지속적으로 개선한다.
9.3 고급 LLM 워크플로
기본 워크플로는 작업과 순서가 정해져 있어 안정적이고 디버깅하기 쉽지만, 미리 설계한 범위를 벗어나는 상황에는 유연하게 대응하기 어렵다. 고급 워크플로는 LLM에 더 많은 자율성을 주어 개방적인 문제를 다룰 수 있지만, 그만큼 예측과 통제가 어려워진다.
1. LLM이 워크플로를 주도
워크플로 자체를 에이전트로 만들어, 상황에 따라 작업을 선택하고 순서를 정하게 할 수 있다. 더 나아가 필요한 작업 에이전트를 즉석에서 만들거나, 여러 작업의 우선순위를 계속 조정하게 할 수도 있다. 이때 에이전트가 대화를 끝없이 이어가지 않도록, 완료 결과를 제출하는 finish 같은 명확한 종료 방식이 필요하다.
2. 상태를 유지하는 작업 에이전트
일반적인 작업은 입력을 받으면 처리한 뒤 끝나지만, 상태 저장 에이전트는 특정 파일이나 자산을 계속 관리한다. 다른 에이전트나 사용자가 변경을 요청하면 해당 내용을 수정하고, 관련 에이전트에 변경 사실을 알릴 수 있다. 다만 서로 의존하는 작업이 순환하며 무한 반복되지 않도록 의존성 관리를 해야 한다.
3. 역할과 위임
각 에이전트에 역할·목표·도구를 부여하고 팀처럼 협력시킬 수 있다. AutoGen은 여러 에이전트를 관리하는 그룹 채팅 구조를 지원하고, CrewAI는 역할과 작업을 가진 에이전트들을 순차적 또는 계층적으로 구성하는 방식을 제공한다. 이런 프레임워크는 편리하지만, 사용 목적에 꼭 필요한지 먼저 따져봐야 한다.
핵심 결론
복잡한 목표는 여러 작은 작업으로 나누고, 가능하면 LLM 없이 일반 코드나 전통적인 머신러닝으로 처리하는 것이 더 안정적이다. LLM이 필요한 단계만 에이전트로 만들고 나머지는 정해진 워크플로로 연결하면 문제를 찾고 개선하기 쉽다. 더 많은 유연성이 꼭 필요할 때 고급 구조를 시도하되, 자율성이 커질수록 신뢰성과 통제는 어려워진다는 점을 고려해야 한다.
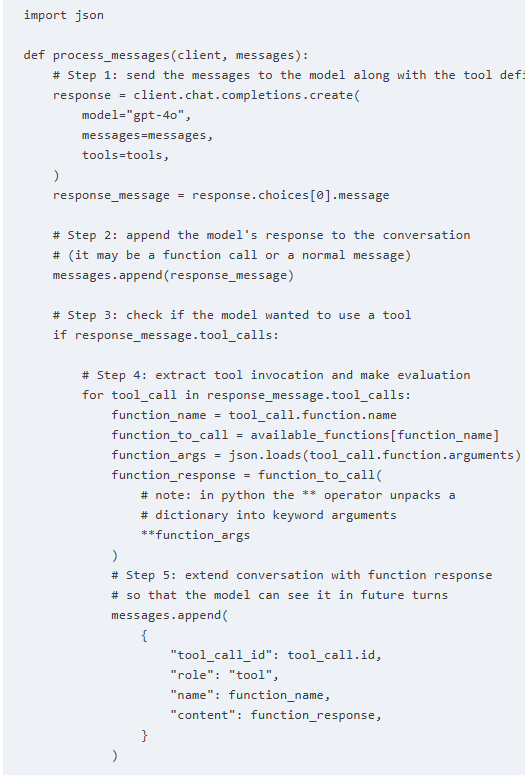
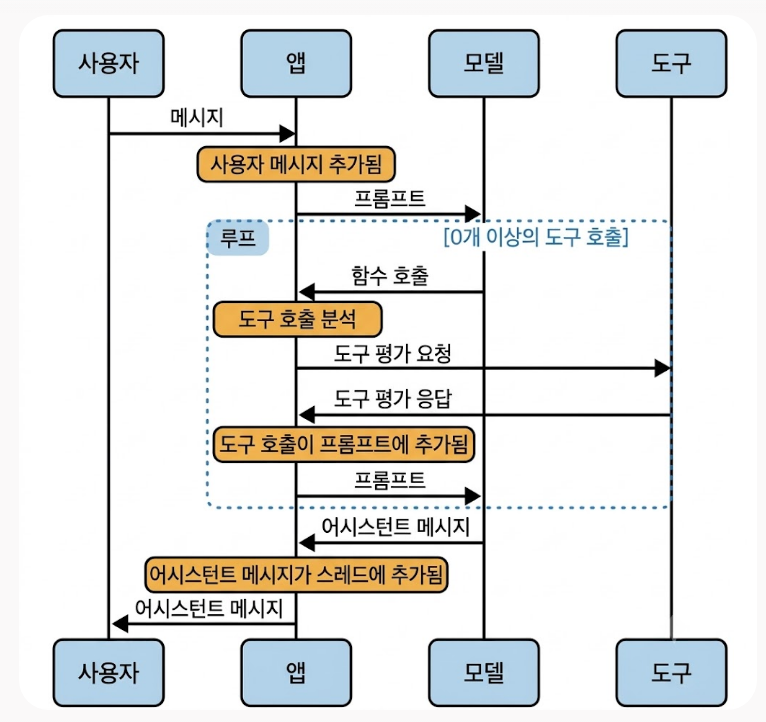
4단계 (실행): 도구 사용이 필요하다면, AI가 지정한 함수 이름과 인자(arguments)를 추출해서 실제 파이썬 함수를 직접 실행합니다.(전에 우리가 만든 리모콘을 실행한다.)
5단계 (결과 추가): 함수를 실행해서 얻은 결과값을 role: "tool" 메시지 형태로 만들어 대화 내역 끝에 붙여줍니다.
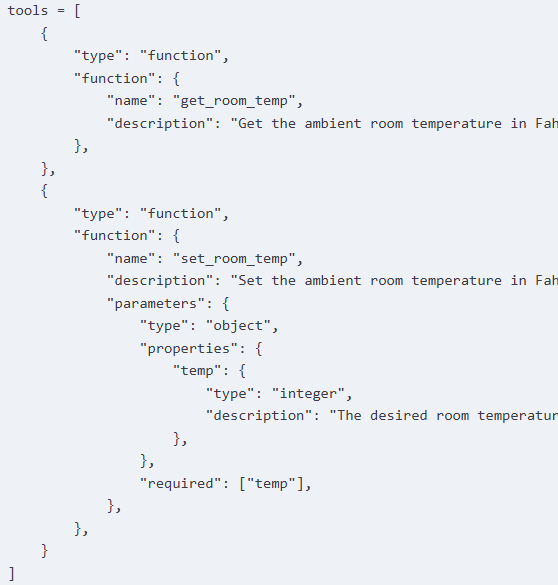
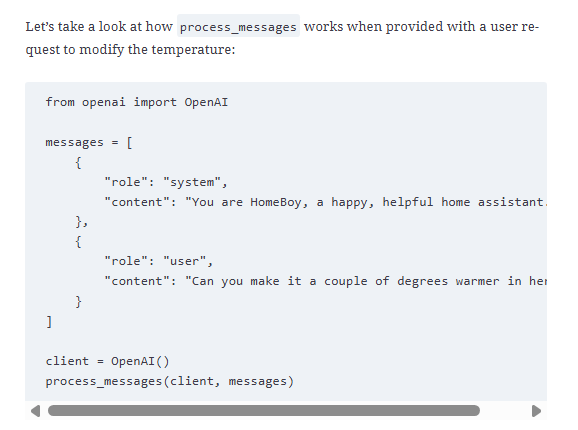
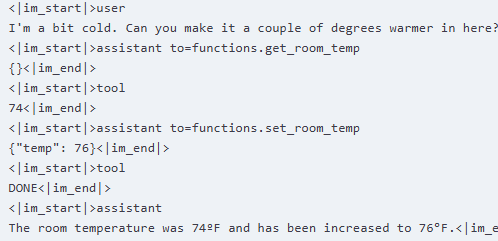
자 이제 다음은 사용자가 온도 몇도 조절해줄래 ? 했을때 과정이다.
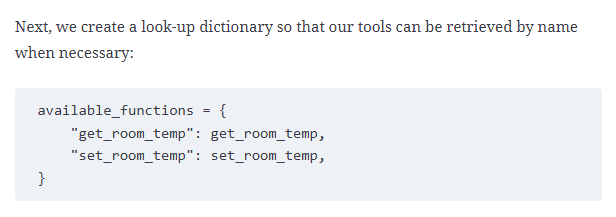
이제 role system user 를 정의하고, process_message 를 호출한다.
process_message는 우리가 도구 호출, 평가, 도작을 정의했던, 함수이다.
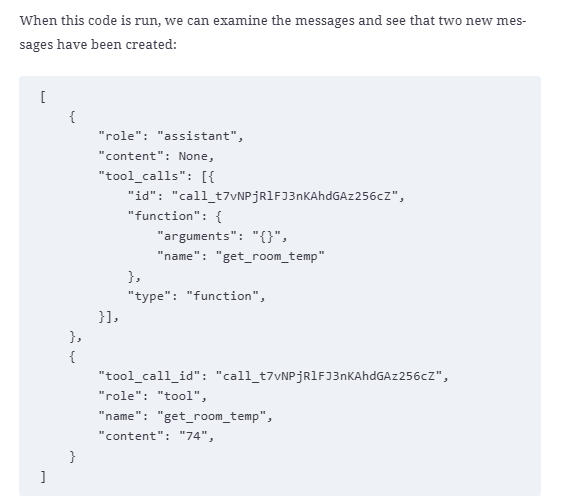
그러면 message 리스트에 2개의 메시지가 추가된다.
1. assistant 가 온도 조절하는 리모콘을 눌러달라는 tool call
2. 실제로 눌렀더니, 74도인 것
하지만 온도를 아는것이 다가 아니다, 실제로 세팅을 해야한다.
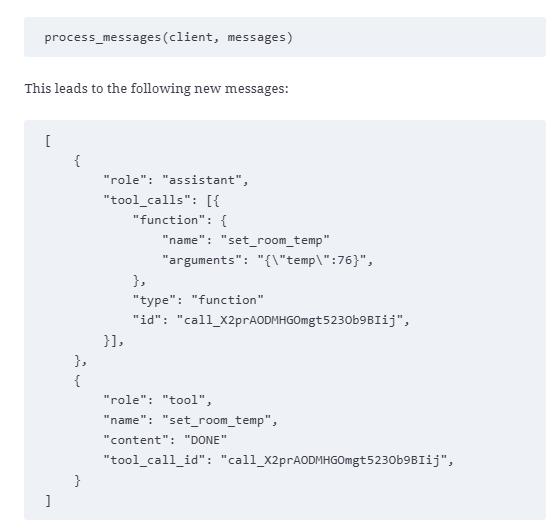
다시 메세지 client 를 세팅하고 process_messages 를 호출(아래)
그럼
1. assistant : 아까 74도였으니까 2도 높여서 76도로 실행해줘.
2. 76도 설정완료.
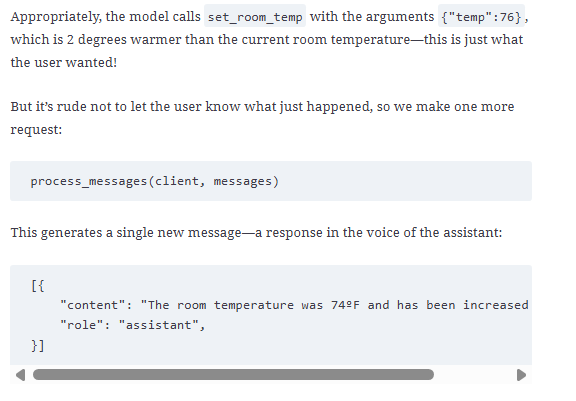
하지만 설정 완료하고 끝이 아니다.
하지만 시스템 내부에서 혼자 처리하고 끝내면 사용자 입장에서는 무슨 일이 일어났는지 알 수 없기 때문에, 사용자에게 결과를 알려주기 위해 마지막으로 process_messages를 한 번 더 호출
2. 내부 작동 원리
겉으로 보기에는 모델이 진짜로 코드를 실행하거나 외부 데이터베이스를 직접 조회하는 대단하고 복잡한 기술처럼 보이지만, LLM 내부에서 일어나는 일은 100% '다음 단어(토큰) 예측' 하나뿐.
( OpenAI는 이 내부 프롬프트 형식을 공식 공개하지 않았습니다.)
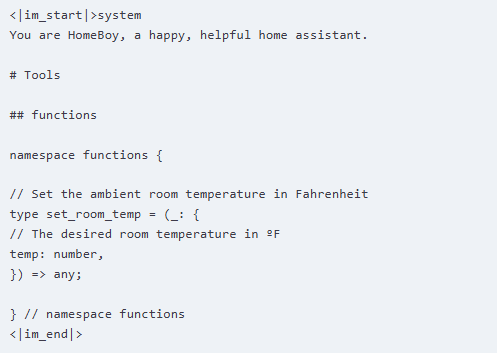
우리가 어떤 내용을 호출하면 위처럼 변환이 된다.
우리가 제공한 코드도 있고, tool, functions 다양한 내용이 있다.
OpenAI API 서버는 개발자가 보낸 위 JSON을 받아서, 모델이 가장 잘 이해할 수 있는 TypeScript 형태의 텍스트로 변환한 뒤 시스템 프롬프트 맨 뒤에 합쳐서 모델에게 전달한다.
즉, 모델에맞춰서 TypeScript 형태로 바꾸어야 하는 가장큰 이유는 :
토큰 절약: JSON 전체 구조를 그대로 주입하는 것보다 TypeScript 인터페이스 형태의 텍스트로 변환하는 것이 토큰 길이가 더 짧습니다.
이해도 향상: 모델은 사전 학습(Pre-training) 때 TypeScript 코드와 주석을 수없이 많이 읽었기 때문에, 이 구문을 만나면 "아, 내가 어떤 인자(Key)와 데이터 타입(Value)을 써서 함수를 불러야 하는구나!"를 훨씬 더 명확하게 파악합니다.(우리가 어셈블러 언어를 배우는 것도 동일한 이치)
우리가 위에서 핑퐁한 대화들의 내용이 여기 있다.
LLM이 assistant to=functions.set_room_temp {"temp": 77}라는 글자를 적을 때, 속으로는
"1. 어시스턴트로 ➔ 2. 도구를 쓰자 ➔ 3. 온도 설정 함수로 ➔ 4. temp 파라미터에 ➔ 5. 77이라는 값을 넣어서 ➔ 6. 끝!"
이라는 6단계 의사결정을 순간적으로 거치며 단어를 하나씩 이어 쓴다는 뜻입니다.
[대화형 AI(LLM)에 사용할 도구(Function/Tool)를 설계할 때 지켜야 할 가이드라인]
. 핵심 전제 (대원칙)
사람이 이해하기 쉬운 것이 LLM에게도 쉽다.
모델이 이미 대량의 학습 데이터로 알고 있는 형식이나 명명법을 그대로 활용하는 것이 가장 효과적
적절한 도구 선택 (Selecting the right tools)
한 번에 제공하는 도구 개수를 최소화하고, 기능이 중첩되지 않도록 역할을 명확히 분리해야 모델의 혼란을 막습니다.
복잡하고 거대한 백엔드 REST API를 그대로 주입하지 말고, LLM 전용으로 단순화된 도구를 만들어 전달하세요.
도구 및 인수 명명 (Naming tools and arguments)
사람이 읽어도 한눈에 의도를 파악할 수 있도록 의미가 명확하고 자가 설명적인 이름을 지정해야 합니다.
retrieveemail처럼 구분 없이 붙여 쓴 소문자 단어는 파싱이 어려우므로 camelCase 같은 명확한 관례를 따르세요.
도구 정의 (Defining tools)
법률 문서처럼 복잡한 용어는 피하고, 모델이 사용법을 직관적으로 이해할 수 있게 가볍고 명확하게 정의하세요.
이미 모델이 잘 알고 있는 공공 API(예: GitHub API 등)를 연동할 때는 기존 문서의 명칭과 스타일을 그대로 따르는 것이 좋습니다.
인수 처리 (Dealing with arguments)
파라미터는 기본 타입(string, number, boolean, enum) 위주로 가급적 적고 단순하게 유지하세요.
대화 맥락에 없는 정보로 모델이 임의의 값을 지어내는 환각을 막으려면 필수 인자를 아예 제거하거나 애플리케이션 기본값을 활용하세요.
출력 처리 (Dealing with tool outputs)
도구의 실행 결과는 모델이 다음에 무엇을 할지 예측할 수 있도록 정형화되거나 깔끔한 텍스트로 전달하세요.
"혹시 몰라 넣은" 불필요한 정보는 모델의 주의를 산만하게 만들어 환각이나 오류를 유발하므로 과감히 제외하세요.
오류 처리 (Dealing with tool errors)
도구 실행 중 에러가 발생하면 내부 시스템 로그를 그대로 던지지 말고, 모델이 이해할 수 있는 형태의 에러 정보로 변환하세요.
유효성 검사 실패 등 모델이 직접 수정 가능한 에러는 무엇이 틀렸는지 알려주어 스스로 재시도할 수 있게 유도해야 합니다.
위험한 도구 실행 (Executing "dangerous" tools)
실제 데이터 삭제나 송금처럼 파급력이 큰 작업은 "사용자 확인을 받으라"는 프롬프트 지시문만으로 안전을 보장할 수 없습니다.
모델이 자유롭게 요청을 보내도록 두되, 실제 외부 API가 호출되기 전 애플리케이션 레이어에서 이를 가로채 사용자 승인을 받는 안전장치를 만드세요.
8.2 추론
LLM은 원래 머릿속으로 생각하는 기능이 없이 단어를 이어 붙일 뿐이므로, 프롬프트를 통해 '단계별로 생각하는 과정(내적 독백)'을 출력하도록 강제해야 답변의 수준이 올라간다.
8.2.1 생각의 사슬
-> 필요한 정보를 넣으면서 질문해보면 성능향상에 도움이 된다.
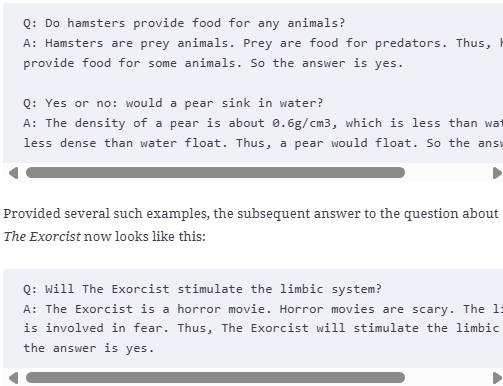
햄스터 예시: "답하기 전에 이유부터 써라"라고 모델을 훈련시키기 위한 교재(Example)
엑소시스트 답변: 그 교재대로 학습해서 이유를 먼저 적다 보니 찍지 않고 정답을 맞춰낸 실전 결과입니다.
-> 즉, 틀릴만한 문제도 이유를 먼저 서술하면서 가는 느낌으로 가면 정답으로 유도될 수 있다.(환각 없어짐)
또한 , 중요한 개념은, 모델이 여러번 요청을 거칠수록 답변의 품질은 올라가고, 모델이 문제에 대해 생각할 시간을 갖도록 조건을 설정하는게 좋다.(품질 향상의 개념에서)
8.2.2 ReAct: 반복 추론 및 행동
사람도 자기 머릿속 지식만으로 바로 답하지 못하고 아래처럼 행동합니다:
생각 (Reasoning): "두 잡지의 창간일을 각각 검색해서 비교해야겠네."
행동 (Action): 구글에 Arthur's Magazine 검색 ➔ 결과 확인
행동 (Action): 구글에 First for Women 검색 ➔ 결과 확인
생각 (Reasoning): "A 잡지는 1844년, B 잡지는 1989년이네. A가 더 빠르다."
결론 (Finish): 최종 대답 출력
이렇게 '생각(Reason)'과 '도구 사용/행동(Act)'을 번갈아 반복하며 다단계 문제(Multistep Problem)를 푸는 패턴을 ReAct라고 부릅니다.
LLM도 똑같다.
Search[entity] = 책장에 가서 책 한 권 뽑아 펼치기
역할: 원하는 주제를 검색해서 위키피디아의 가장 첫 5문장(개요)을 읽어옵니다.
쉽게 말해: "위키피디아에서 Arthur's Magazine 책 좀 찾아와서 맨 첫 페이지 읽어봐!" 하는 것입니다.
Lookup[string] = 책 안에서 특정 단어 찾기 (Ctrl + F)
역할: 방금 펼쳐둔 책 안에서, 내가 찾고 싶은 특정 단어(예: "창간일", "출판")가 들어간 다음 문장을 찾아 읽습니다.
쉽게 말해: "책 내용은 너무 길니까, 그 책 안에서 1844년이나 출판이라는 단어가 들어간 부분만 바로 찾아서 읽어봐!" 하는 것입니다.
Finish[answer] = 정답지에 답 적고 제출하기
역할: 정보를 충분히 모아서 답을 알게 되었을 때, 검색을 멈추고 최종 답을 사용자에게 내놓습니다.
쉽게 말해: "이제 답 찾았으니까 검색 그만하고, *'Arthur's Magazine이 더 먼저 나왔습니다'*라고 정답 제출하자!" 하는 것입니다.
8.2.3 ReAct를 넘어
ReAct 가 LLM 애플리케이션에서 추론 능력을 개선하는 데, 매우 중요한 진전을 이룬건 맞지만 마지막은 아님.
1. Plan-and-Solve (먼저 계획부터 세우기)
방식: 다짜고짜 문제 해결(검색/행동)에 뛰어들지 않고, 전체적인 계획부터 먼저 세운 뒤 단계별로 문제를 풀게 만듭니다.
핵심 프롬프트: "먼저 문제를 이해하고 해결 계획을 수립하자. 그다음 그 계획에 따라 단계별로 문제를 풀어보자."
특징: 도구(검색)를 쓰기 전에 전체 그림을 그려보게 하여 논리적 실수를 줄이는 방법입니다.
2. Reflexion (자기 반성 및 피드백)
방식: 일이 끝난 뒤 자신이 한 작업 결과를 되돌아보고(Review), 어디가 잘못되었는지 반성하여 다음번 계획을 수정하게 만듭니다.
실제 활용 예시 (코드 작성):
모델이 코드를 작성합니다.
단이 테스트(Unit Test)를 돌렸는데 에러가 발생합니다.
실패 메시지를 모델에게 다시 보여주면, 모델이 반성하고 코드를 수정하여 재시도합니다.
3. Branch-solve-merge 작동 방식
Branch (가지치기): 하나의 문제를 $N$개의 서로 독립된 LLM 대화 세션(Solvers)으로 나눕니다.
Solve (해결하기):
높은 Temperature(창의성 수치)를 주어 각자 다르게 시도하게 만들거나, 서로 다른 관점(Perspective)에서 문제를 해결하도록 프롬프트로 지시합니다.
Merge (병합하기): 모든 AI가 답을 내놓으면, 이를 병합 전담 AI(Merging Agent)에게 전달하여 3개의 결과물을 종합한 더 뛰어나고 완성도 높은 최종 해결책을 만듭니다.
-> 계획-해결 프롬프트가 ReAct에 선제적인 계획 단계를 추가해 보완하는 방식이라면, Reflxion 방식은 정반대의 접근법을 취한다.
1. "Plan-and-Solve는 외부 도구를 쓰는 기법이 아니라, CoT처럼 내부 추론만 이용하되 '실제 문제를 풀기 전 전체 계획부터 먼저 세우도록' 강제하는 프롬프팅 기법"
2. "Reflexion"은 ReAct처럼 작업을 수행한 뒤, "내가 방금 한 작업의 결과물을 평가(Review)하고, 틀린 이유를 스스로 반성(Self-Reflection)하여 다음 시도에 반영하는 피드백 루프 방식"입니다.
3. "Branch-solve-merge는 여러 AI에게 다양한 관점으로 풀어보게 한 뒤 종합하는 방식이며, 지금까지 나온 모든 기법은 AI에게 '생각하는 시간(내적 독백)'을 주기 위한 도구들"
8.3 작업 기반 상호작용을 위한 콘텍스트
프롬프트를 만드기 위해 콘텍스트를 선택하고 구성할때 고려해야할 사항
1. 어떤 도구(Tool)가 필요한가?
대화 맥락상 지금 쓰이지 않을 도구 정의는 프롬프트에서 제외(Drop)하여 AI가 딴길로 새지 않게 주의를 줄여줍니다.
2. 어떤 데이터(Artifacts)를 포함할 것인가?
모두 포함하기: 정보는 완벽하지만, 불필요한 데이터가 많아져 AI가 혼란을 느낄 수 있습니다.
AI에게 선택하게 하기: AI에게 필요한 데이터만 고르게 만드는 별도 요청 과정을 거칩니다 (시스템 복잡도 증가).
3. 데이터를 어떤 형식으로 보여줄 것인가?
<artifact> 같은 XML 태그나 ## Attached Data 같은 마크다운 구획을 활용해 텍스트/JSON 형태로 직접 넣습니다.
또는, 도구 호출 기록(Function Call history) 자체를 대화 기록에 그대로 보존하여 자연스럽게 전달하는 방법도 있습니다.
4. 데이터 양은 얼마나 넣어야 하는가?
책 전체 내용을 다 넣을 수 없듯, 필요한 핵심만 추출해야 합니다.
요약 + 상세 조회 도구: Bullet 요약만 보여주고, 더 필요한 부분은 details('section 5')처럼 함수를 호출해 펼쳐보게(Unfurl) 만듭니다.
RAG(검색) 활용: 큰 데이터는 전통적인 RAG 방식을 통해 필요한 부분만 검색해서 주입합니다.
5. 이전 대화 기록은 얼마나 과거까지 유지할 것인가?
주제가 바꼈거나 일정 시간 반응이 없으면(Timeout) 과거 대화를 잘라냅니다.
작은 모델을 별도로 학습시켜 관련 있는 과거 대화만 골라내도록 선별할 수도 있습니다.
8-4. 대화형 에이전트 구축
8.4.2 사용자 경험
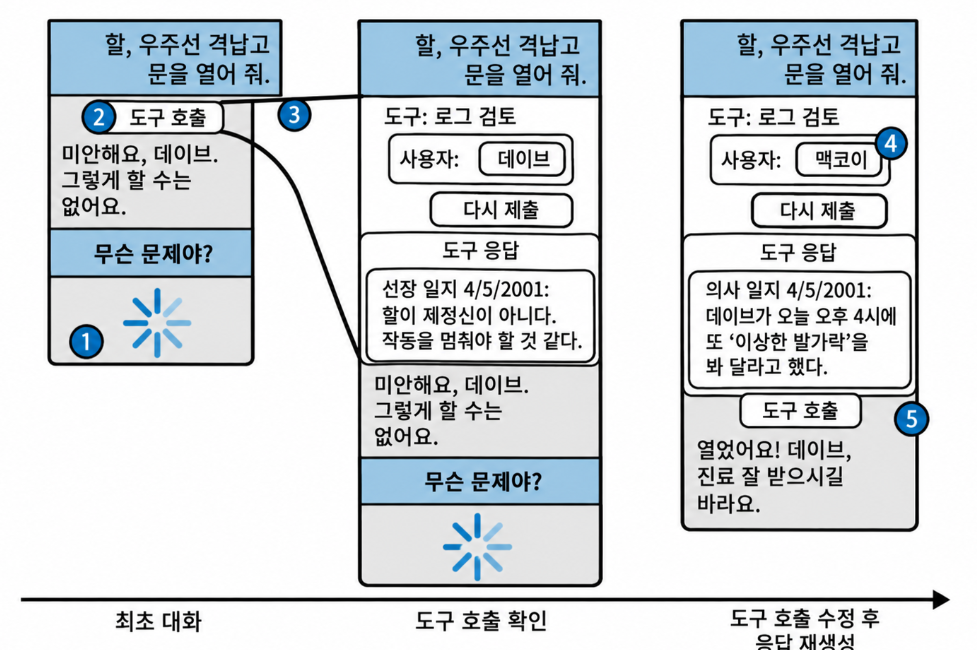
왜 이 이름들이 나왔는지 딱 3초 요약
Dave(데이브) & HAL(할): 영화 《2001 스페이스 오디세이》에 나오는 사람(Dave)과 우주선 AI(HAL)입니다. 영화에서 AI가 고장 나서 사람을 우주선에 안 들여보내주는 유명한 장면이 있습니다.
McCoy(맥코이): 영화 《스타트렉》에 나오는 의사 캐릭터 이름입니다.
아무튼, 사용자를, 데이브, 맥코이로 사용자가 변경했을때, 결과가 달라진다.라는걸 보여주는것 이다.
즉, "AI가 함부로 사고 치지 않게 UI로 안전장치를 만들어라"
위험한 작업은 꼭 승인받기
AI가 결제, 예약, 데이터 삭제처럼 실제 돈이나 시스템을 건드리는 작업을 할 때는 실행 전 사용자에게 [승인 / 취소] 팝업을 띄워 확인을 받아야 합니다.
AI가 보고 있는 화면 보여주기
AI가 내 화면의 어떤 문서나 데이터를 읽고 답변 중인지 사용자가 볼 수 있게 해줘야 합니다.
AI가 엉뚱한 문서를 참고하고 있으면 사용자가 해당 문서를 닫아서 대화가 딴길로 새는 걸 막을 수 있습니다.
완성 결과이든 대화의 응답이든 그 결과가 어떻게 나타나는지 확인하며, 불필요한 레이턴시나 혼란스러운 세부 사항 같은 문제를 피하면서 명확하고 효과적인 해결책을 보장하기 위해 우리가 이 출력을 어떤 형태로 만들고 싶은지 다룬다.
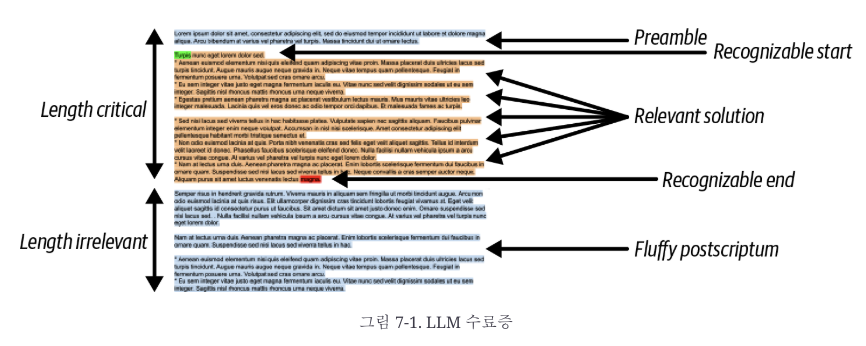
LLM의 답변은 서문, 핵심 답변, 후기로 나뉘며, 필요한 부분의 시작과 끝을 명확히 하면 답변을 쉽게 추출하고 불필요한 생성을 줄일 수 있다.
LLM 응답 결과 (구성)
7.1.1 서문
서문 : 결과 콘텍스트에서 생성된 텍스트 초반부로, 핵심 내용이 나오기 전 배경을 설정해주는 부분
# 예시 새로운 일을 시작할 때는 누구나 막막함을 느낍니다. → 주제 제시: 새로운 일을 시작할 때의 어려움 오늘은 제가 직접 시도하며 배운 작은 실천 방법들을 나누려 합니다. → 글의 목적·내용 소개: 무엇을 이야기할지 알려줌 이 글이 여러분의 첫걸음에 도움이 되길 바랍니다. → 글을 쓰는 의도: 독자에게 어떤 도움이 되길 원하는지 제시
텍스트의 낭비로 보는 측면도 있지만, 필요한 경우도 있으니 이율배반적이라 표현하기도 한다.
서문의 세가지 유형 정리
1. 구조적 상용구(structural boilerplate)
출력 형식을 유도하는 고정 문구는 모델이 생성하게 하기보다 프롬프트에 미리 넣는 편이 효율적이다.
# 구조적 상용구 예시 > 결과가 어떤 구조로 나와야 하는지 뼈대를 미리 만들어 놓은 것. 다음 구조에 맞춰 제품 리뷰를 작성하세요. ## 제품 소개 {제품에 대한 간단한 소개} ## 장점 {장점} ## 단점 {단점} ## 총평 {최종 평가}
2. 추론형 서문
바로 답하게 하기보다 문제를 작은 단계로 나누고 조건을 차례로 검증하게 하면 오류를 줄이고 정확도를 높일 수 있다.
추론은 정답을 장황하게 꾸미는 설명이 아니라, 답을 내기 전에 문제와 조건을 점검하는 과정이다.
CoT 프롬프트는 이러한 단계적 추론을 유도하며,
이때 생성되는 추론 서문은 길더라도 단순한 군더더기가 아니라, 복잡한 문제의 정확도를 높이는 유용한 과정일 수 있다.
# 추론형 서문 예씨 다음 조건을 모두 만족하는 동물을 찾아라.1. 새끼를 낳는다.2. 다리가 네 개이다.3. 검고 흰 줄무늬가 있다.4. 말과 비슷하게 생겼다. 각 조건을 확인한 뒤 정답을 제시하라.정답: 얼룩말
3. 무의미한 서문(fluff preamble)
없어도 정답을 이해하는 데 문제가 없는 앞부분을 뜻함
RLHF로 학습된 모델은 무의미한 서문을 포함할 가능성이 높다.
▶ RLHF 모델은 사람들이 선호하는 친절하고 안전한 답변을 생성하려다 보니, 핵심 답변 앞뒤에 쿠션어·부연·주의사항을 덧붙이는 경향이 있음.
# 예시 1.질문: 프랑스의 수도는 어디인가?2. 무의미한 서문이 포함된 답변 좋은 질문이다. 프랑스는 역사와 문화가 풍부한 나라이다. 질문에 답하자면 프랑스의 수도는 파리이다.3. 간결한 답변 : 프랑스 수도는 파리이다.
이를 해결하기 위해 few-shot 예시를 포함한 지시문을 제공하거나 주요 답변과 추가 설명을 분리하는 프롬프트 재구성 같은 기법을 사용.
but, 그만큼 비용이 많이 듬.
7.1.2 명확한 시작부와 종료부
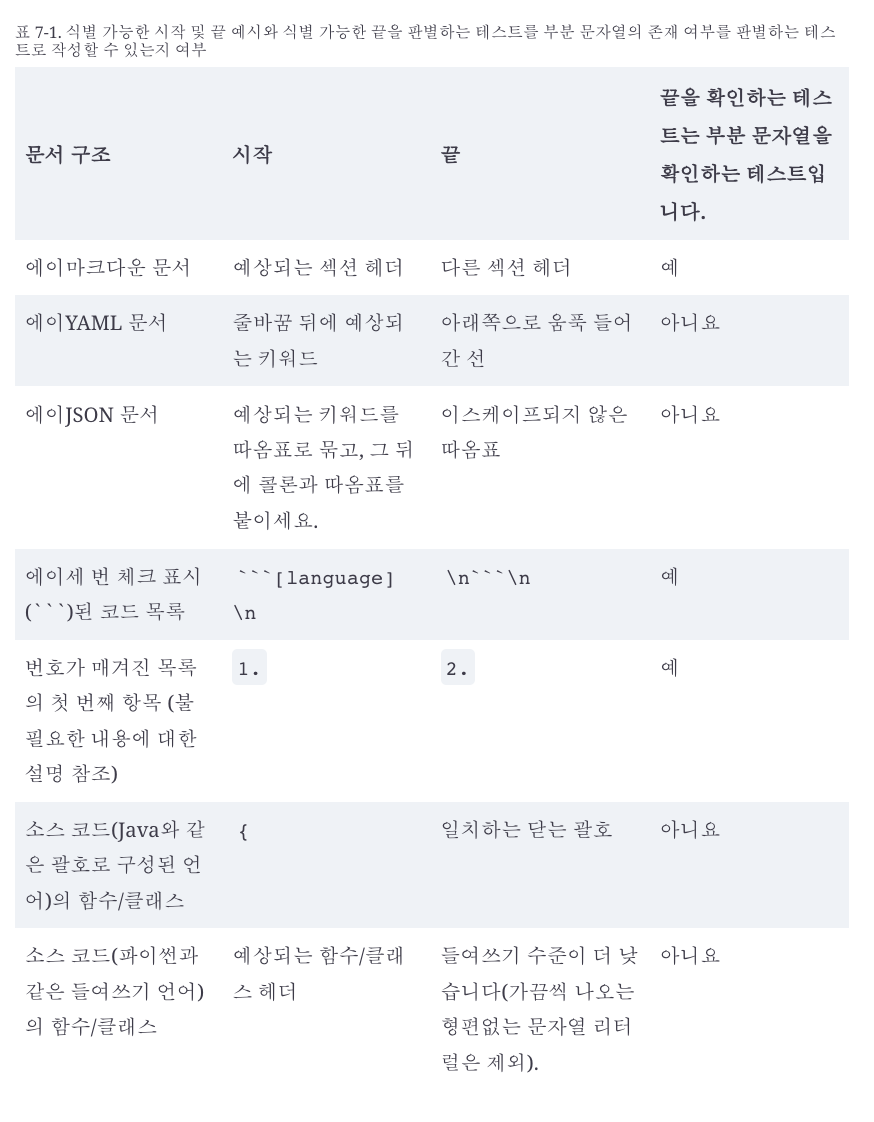
LLM의 응답에서 주요 답변을 추출하고 싶다면 시작과 종료를 명확하게 인식할 수 있어야한다.
LLM의 답변을 프로그램에서 사용할 때는 내용뿐 아니라 시작과 끝을 쉽게 찾을 수 있는 출력 형식을 설계해야 한다.
※ 문자열 종료부 테스트 가능 여부에 따른 의미
예 : ##, 2., 닫는 백틱처럼 특정 문자열을 찾으면 된다.
아니요 : 들여쓰기, 괄호 짝, 이스케이프 여부 등 구조를 해석해야 한다.
# 아니요 예시 -> explanation 이놈의 들여쓰기가 있나 없나 주변 문맥 구조 파악까지 해야함 answer:city: Paris country: France explanation:text:...
7.1.3 마무리 부분
질문과 관련 없는 마무리 부분(postscript)을 걸러낼 수 있어야 명확히 인식할 수 있다.
LLM 답변의 ‘식별 가능한 시작과 끝’을 설계하는 것에 대한 두 가지 고려 사항.
답변을 분석하기 위한 고려 사항 : 시작과 끝을 명확히 구분해 핵심 답변만 추출하고, 불필요한 서론과 결론을 걸러내는 것.
2. 답변 생성을 제어하기 위한 고려 사항 : 핵심 답변의 끝을 인식하는 순간 토큰 생성을 중단해 응답 시간·연산량·비용을 줄이는 것.
토큰 생성을 중단하는 두 가지 주요 방법
종료 문자열(stop sequence) : 지정한 문자열이 나오면 서버에서 생성을 즉시 중단
# 마크다운 종료 문자열 : ₩n#
2. 스트리밍 모드(streaming mode) : 토큰을 실시간으로 받아 끝을 감지한 뒤 생성을 취소
※ 스트리밍 모드는 특정 문자열 방법을 추가하여 강화 가능함.
1. 종료 문자열 개발자가 지정 \nclass \nif \ndef 2. 사용자 요청 질문: dog의 울음 소리를 출력하는 function 성생해줘.3.LLM이 답변 생성 중 classDog: def bark(self):print("멍멍") def main(): # 줄 맨 앞의 def → 여기서 생성 중단 4. 답변 반환 classDog: def bark(self):print("멍멍")
7.2 텍스트를 넘어서 : 로그 확률 (Logprobs)
로그 확률(Logprob) : 모델이 각 토큰을 얼마나 가능성 높은 선택으로 판단했는지 나타내는 값.
0에 가까울수록 확신이 높고, 더 큰 음수일수록 가능성이 낮다.
▶ 일부 상용 모델은 API 중 로그 확률을 제공하는 기능을 비활성하고 있음.
모델의 내부 동작이 과도하게 노출되어 역공학의 대상이 될 가능성이 우려되기 때문.
7.2.1 응질 품질 평가
로그 확률 : 각 토큰 선택에 대한 모델의 확신도를 나타냄.
답변 전체의 품질을 추정할 때는 토큰별 로그 확률의 평균을 활용할 수 있다.
평균값은 절대적인 품질 기준은 아니지만, 애플리케이션의 기능별 동작을 결정하는 임계값으로 활용할 수 있다.
# 기능별 동작 예시 1. 모델의 확신이 높을 때만 교정 결과를 보여줘라.2. 모델이 평소보다 불확실해하는 경우 경고 메시지를 띄워라.3. 모델이 불확실해하는 경우 콘텍스트를 추가하거나 재시도해라.4. 더 나은 결과가 필요한 경우 성능이 좋으면서 비용이 더 많이 드는 LLM으로 전환해라.5. 모델이 사용자에게 도움이 필요하다는 확신이 높을 때만 개입한다. 즉, 확신이 낮으면 경고, 재시도, 추가 맥락 제공 또는 더 강력한 모델 전환을 적용할 수 있다.
7.2.2 LLM을 분류에 활용하는 방법
분류(classification) : 어떤 사례가 사전 정의된 여러 범주 중 어디에 속하는지 결정하는 기본 머신러닝 작업.
정해진 범주 내에서 모델은 정답을 고르고 그 선택에 대한 확신 정도를 평가하는 것이 핵심
▶ 프롬프트 엔지니어는 모델이 여러 대안 중 정확히 하나를 선택할 수 있도록 프롬프트를 잘 설계해야한다.
잘 설계하는 방법은 LLM에게 직접 질문 하는 것!
LLM에 긍정·부정·중립처럼 고정된 선택지 중 하나를 고르게 하는 것.
모델의 응답에서 최대한 애매모호한 답변은 피하며 어떤 범주가 등장했는지 파악한다.
추가로, 보다 정제된 형태로 질문하는 것이 좋다.
# 형식 지정 또는 구조화된 출력 지시 이 문장은 긍정, 부정, 중립인가? 다음 형식으로 답해라.1.[부정 | 긍정 | 중립]> # 명확한 시작 지점 2.[설명] 명확한 시작 지점인 '1'번만 보면 해당 질문의 분류 결과를 알 수 있따. 명확한 시작 지점 :LLM 답변에서 실제 답이 어디서 시작하는지 프로그램이 쉽게 찾을 수 있도록 만든 표시
보정(calibration) : 분류 결과에 대한 확신도를 실제 기준에 더 가깝게 맞추는 작업
사전 예측의 확신도는 로그 확률이며, 모델은 로그 확률이 가장 높은 토큰을 생성함.
모델의 분류 기준이 서비스 기준과 다르면 logprob에 상수를 더해 판단 임계점을 조정한다.
# 보정 예시 이메일을 차단하는 애플리케이션이 있고, 분류를 통해 예, 아니요의 로그 확률 차이를 기반으로하여 차단을 진행한다. 차단 기준 : 로그 확률이 0에 가까운 값을 기준 예:-0.5아니요:-0.3 but, 너무 많은 차단이 있어났을 경우, 보정을 통하여 차단 조건을 지정 차단 조건 : 아니요의 로그 확률이 예의 로그 확률보다 0.3 이상 높을 때 위의 예는 0.2 이므로 차단 하지 않음 즉, 보정은 로그 확률에 기준값을 적용해 모델의 분류 기준을 실제 사용 목적에 맞추는 과정.
7.2.3 프롬프트 내 핵심 지점
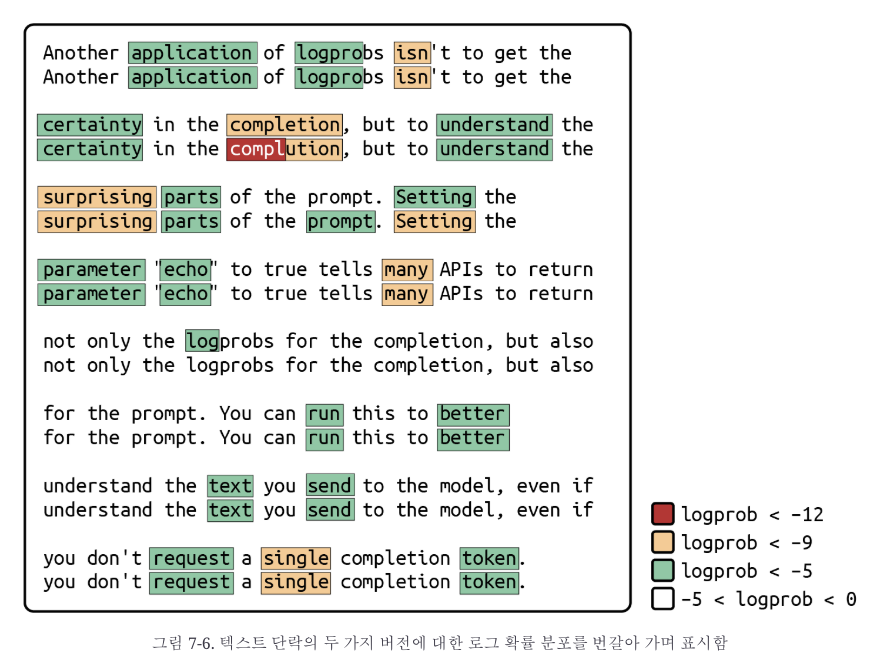
프롬프트의 logprob를 확인하면 오타나 모델이 예상하지 못한 표현을 찾을 수 있다.
echo 파라미터를 true로 설정 했을 시, 프롬프트에 대한 로그 확률을 반환한다(대부분의 API)
응답 토큰을 전혀 생성하지 않고, 사용자가 모델에 전송한 텍스트를 더 잘 이해할 수 있다.
매우 낮은 값은 문장에서 낯설거나 정보 밀도가 높은 지점을 나타낼 수 있다.
정상 단어인 completion 대신 오타인 complution이 등장하자, 모델은 이를 예상하기 어려운 표현으로 판단한다.
그 결과 해당 부분의 로그 확률이 -13 미만으로 크게 낮아져 눈에 띄게 나타난다.
즉, 모델에게 직접 “오타를 찾아라”라고 질문하지 않아도, 로그 확률이 비정상적으로 낮은 지점을 확인해 오타나 특이한 표현의 위치를 찾을 수 있다.
7.3 모델 선택
모델은 특정 순위보다 애플리케이션의 요구사항을 기준으로 선택해야 한다.
주요 선택 기준
지능: 복잡한 추론과 정확한 답변 능력이다.
속도: 응답을 기다리는 시간이다.
비용: API 또는 GPU 사용 비용이다.
사용 편의성: 배포·운영·캐싱 등의 부담이다.
기능성: 채팅, 도구 사용, 이미지 처리, logprob 지원 여부이다.
특수 요건: 오픈소스, 데이터 위치, 보안, 라이선스 등의 조건이다.
일반적으로 작업을 안정적으로 수행할 수 있는 가장 작은 모델을 선택한다.
단순하고 요청량이 많으면 작은 모델이 적합하고, 요청량이 적지만 난도가 높다면 고성능 모델이 유리하다.
다음 순서로 모델을 선택한다.
서비스 제공자를 선택한다.
필요한 기능을 제공하는 모델을 추린다.
작업을 안정적으로 수행하는 가장 작은 모델을 선택한다.
오픈 모델을 직접 호스팅하면 통제 범위가 넓지만 많은 운영 노력이 필요하다.
애플리케이션 규모가 충분히 크거나 데이터·라이선스 조건상 상용 서비스가 부적합할 때 고려하는 편이 좋다.
모델 교체 가능성도 고려해야 한다. 특정 모델 API를 코드 전체에 고정하기보다 여러 모델을 같은 방식으로 호출할 수 있는 구조를 사용해야 한다.
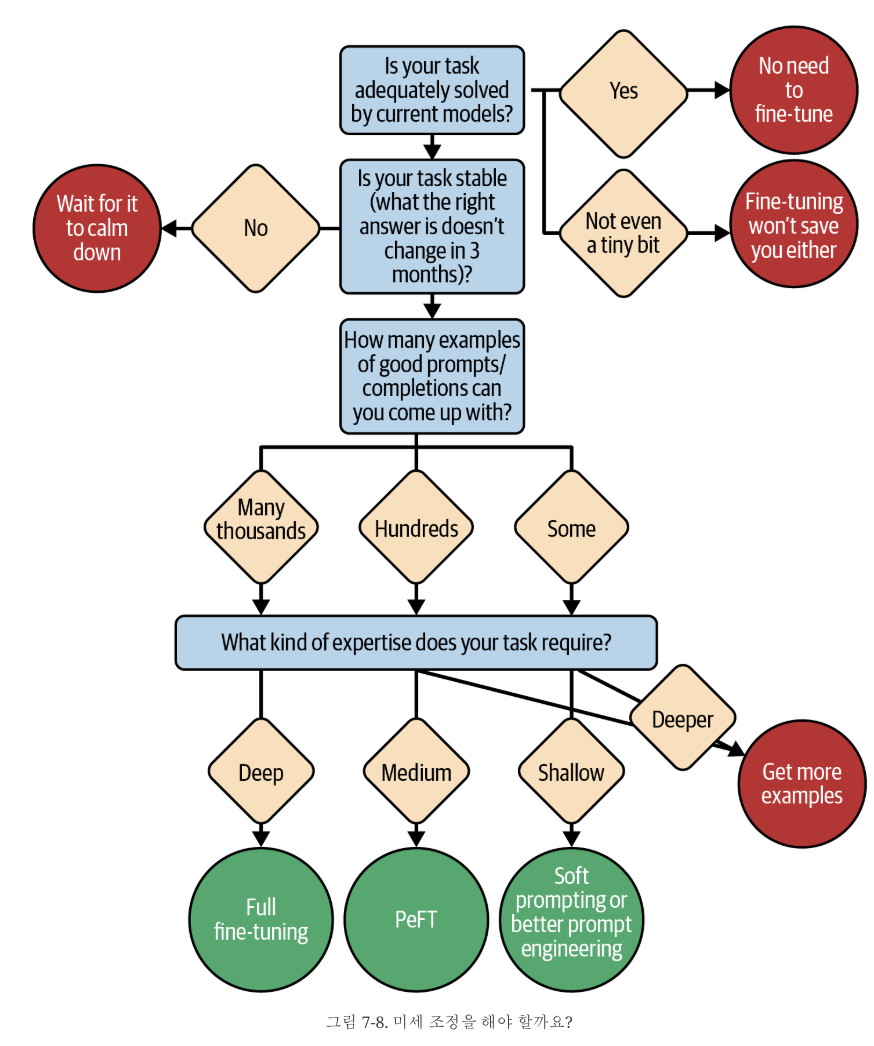
파인튜닝 : 기존 모델에 각자의 애플리케이션 용도에 맞게 직접 학습시키는 것
정확하고 성공적인 상호작용 사례를 학습 자료로 준비해야 함.
예시 데이터 수집 여부에 따라 파인튜닝을 할 가치가 있는지 여부를 결정하는데 큰 핵심 기준이 된다.
파인튜닝을 해야하는지 확인하는 다이어그램
Loss masking : 모델을 학습할 때, 특정 토큰의 실수는 손실값(loss) 계산에서 제외하는 방법이다.
모든 파인튜닝에서 필수인 것은 아니고, 학습 목적에 따라 달라진다.(대화형 모델의 지도 파인튜닝 등등)
# Loss masking 예시 사용자: 대한민국의 수도는 어디인가? → 읽고 참고하지만 손실 계산 제외 모델: 대한민국의 수도는 서울이다. → 손실을 계산해 학습 즉, 질문은 조건으로 참고하되, 그대로 따라 출력하도록 학습하지 않는 것
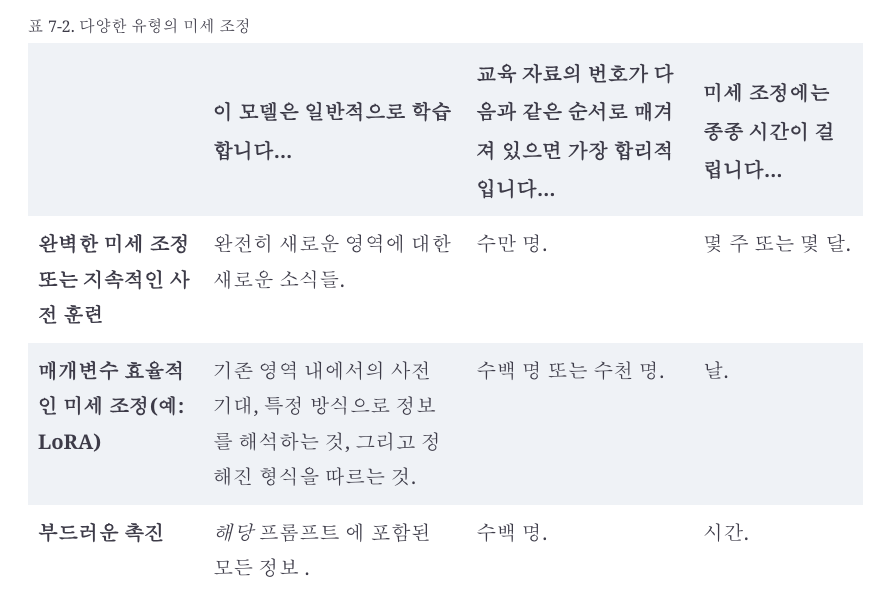
학습 문서를 얼마나 확보하는냐에 따라 파인튜닝 방식이 달라진다.
1. 전체 파인튜닝 and 지속적인 사전 학습
모든 파라미터를 조정해 새로운 지식이나 분야를 학습시킨다. 수만 개의 문서와 많은 시간·연산 자원이 필요하다.
2. LoRA(low-rank adaptation)
일부 파라미터의 차이만 학습하는 효율적인 방식이다. 새로운 지식보다는 형식, 스타일, 정보 해석법, 분야별 선호도를 익히는 데 적합하다.
3. 소프트 프롬프팅
원하는 출력을 만드는 모델 내부 상태를 학습한다. 적은 자료와 짧은 시간이 들지만 모든 모델 환경에서 지원되지는 않는다.
파인튜닝 유형
파인튜닝된 모델에선 빨간 모자 원칙이 다르게 적용된다.
※ 빨간 모자 원칙 : LLM이 프롬프트를 보고 “이 문서는 앞으로 어떤 형태로 이어질 것인가?”를 예측해, 익숙한 경로를 따라간다는 의미
파인튜닝으로 학습된 모델은 두 가지 경로가 만들어짐.
1. 기존 경로: 원래 사전 학습에서 익힌 형식과 행동
2. 새로운 경로: 파인튜닝 데이터로 새롭게 익힌 형식과 행동
따라서 파인튜닝을 했더라도 프롬프트가 기존 학습 문서와 비슷하면 모델은 기존 행동으로 돌아갈 수 있다(파인튜닝 효과 악화시킴).
그렇기에, 변형된 빨간 모자 원칙을 적용해야한다.
프롬프트는 파인튜닝에서 사용한 문서의 시작처럼 보이게 구성해야한다.
절대 기존 학습에 사용된 문서처럼 보이지 않도록 주의해야 한다.
# 파인튜닝 예시 리뷰: 배송이 빠르고 제품의 품질도 좋다.판정: 긍정 리뷰: 포장이 훼손된 상태로 도착했다.판정: 부정 즉, 리뷰 입력이 있으면,판정: 다음에 긍정 또는 부정 값이 들어오도록 학습 # 파인튜닝 경로를 따르는 프롬프트 리뷰: 배송이 빠르고 제품의 품질도 좋다.판정: # 모델 답변 → 정해진 입력 형식에 따라 특정 형식으로 답변한다. 긍정 # 기존 학습 경로를 따르는 프롬프트 가격은 비싸지만 성능은 만족스럽다는 리뷰를 읽고, 고객의 감정과 평가를 자세히 설명해 줘. # 기존 학습된 답변 → 일반적인 질문에 자연어로 자세히 답변한다. 고객은 제품 가격에는 부담을 느끼고 있지만, 성능에 대해서는 전반적으로 만족하고 있다. 따라서 긍정과 부정이 함께 나타나는 복합적인 평가로 볼 수 있다.
즉, 프롬프트의 모양이 어느 학습 패턴과 더 닮았는가에 따라 모델의 답변 방식이 달라질 수 있다
7.4 요약
모델을 길들이려면 답변의 시작과 끝을 통제하고, logprob로 확신과 이상 지점을 분석하며, 목적에 맞는 모델을 선택해야 한다.