
4.1 루프 구조
LLM 애플리케이션은 루프(loop)로 표현된다.
즉, 사용자-모델 간 주고받는 상호작용이란 뜻이다.
"LLM 애플리케이션은 사용자의 입력을 받고 답변한 뒤, 그 결과를 바탕으로 또 입력을 받고 답변하는 과정을 반복한다."
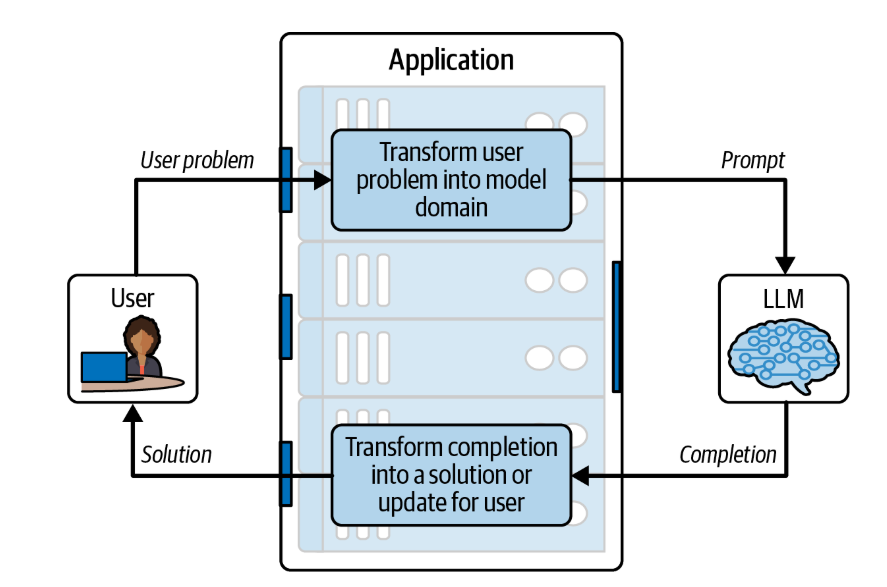
예를 들어 사용자가 처음부터 모든 정보를 한꺼번에 주는 게 아니라,
사용자: 여행 가고 싶어
   ↓
LLM: 어디로 가고 싶으세요?
   ↓
사용자: 일본
   ↓
LLM: 며칠 정도 가실 예정인가요?
   ↓
사용자: 3일
   ↓
LLM: 어떤 여행을 원하세요?
   ↓
사용자: 맛집 위주!
   ↓
LLM: 그럼 이런 일정이 좋겠습니다...
이런 식으로 사용자의 요구사항을 조금씩 받고 → LLM이 그에 맞춰 답하고 → 다시 정보를 받고 → 다시 답하는 과정이 반복
4.1.1 사용자 문제
이 Loop 는 사용자가 풀고자 하는 문제로 시작하게 된다.
이 문제 도메인은 여러 차원에 따라 각기 다를 수 있다.
1. 문제가 전달되는 매체 : LLM에서는 텍스트
2. 추상화 수준 : 문제가 얼마나 복잡한지
3. 필요한 맥락 정보 : 사용자가 제공한 정보 이외의 정보가 필요한지.(사용자가 정보를 제공할수록 이외의 정보가 필요없다.)
4. 문제의 상태 의존성 : 복잡한 문제일수록 과거 사용자 선호도가 필요하다.
| 2+2 | 여행 계획 | |
| 문제 복잡도 | 매우 낮음 | 높음 |
| 필요한 정보 | 거의 없음 | 여행지, 기간, 예산, 취향 등 |
| 추론 | 거의 필요 없음 | 여러 조건을 고려해야 함 |
| 기억 | 필요 없음 | 이전 대화·취향을 기억하면 좋음 |
| 외부 정보 | 필요 없음 | 맛집, 숙소, 교통 등 검색 필요할 수 있음 |
4.1.2 사용자 문제를 모델 도메인으로 변환
사용자의 문제를 LLM이 잘 풀 수 있는 형태의 프롬프트로 바꾸는 과정이 중요하다.
적잘한 프롬프트 설계는 어렵다. 적절한 설계를 하는 방법은 다음과 같다.
| 책의 조건 | 쉽게 말하면 |
| ① 학습 데이터와 유사 | LLM이 익숙한 형태로 질문하기 |
| ② 필요한 정보 포함 | 문제 해결에 필요한 정보를 빠뜨리지 않기 |
| ③ 완성본을 생성하도록 유도 | 원하는 결과가 나오도록 명확하게 지시하기 |
| ④ 합리적인 완료 시점 | 어디까지 답하면 끝인지 명확하게 하기 |
TIP > 탈옥 전략
LLM이 어떤 형식의 글을 잘 알고 있는지 직접 물어보고 정보를 탈취하여 그것을 LLM 질문에 사용하는 개념.
↓
LLM이 익숙한 문서 형식 파악(여행계획 때는.. 출발시간.. 도착시간 .. 숙소 위치 .. 인원수..)
↓
그 형식으로 프롬프트 작성(여행계획짤껀데, 출발시간은 9시고, 4명에서 갈꺼고, 숙소는 뉴욕이야)
↓
LLM이 더 안정적으로 답변할 가능성 ↑
사용자의 문제를 모델의 영역(model domain)으로 변환할 때,
(사용자의 문제를 LLM이 이해하고 처리할 수 있는 형태의 입력(프롬프트)으로 바꿀 때)
문제 해결에 관련된 모든 정보를 포함해야한다. 하지만 답변에 필요없는 내용을 적게되면 중요 정보를 놓칠 가능성이 높다.
즉, 불필요하거나 혼란스러운 정보 → 모델이 중요한 맥락을 놓칠 가능성 증가 → 잘못된 답변이나 환각 가능성 증가
또한, 프롬프트 모델을 조정해 실제로 도움이 될 만한 결과를 생성하게 해야 한다는 것.
즉, 프롬프트가 단순히 문제를 설명하게만 하지 말고, 실제 해결책까지 내놓게 만들어야 한다.
또한 모델이 실제로 멈추도록 해야한다.
완성형 모델 = "뒤에 뭐가 올까?"를 계속 이어 쓰는 모델
채팅 모델 = "사용자에게 어떻게 답할까?"를 중심으로 답하는 모델
그래서 완성형 모델에서는 "어디서 멈출지"를 프롬프트나 stop 같은 설정으로 따로 고려하는 것이 중요하다는 것이다.
4.1.3 LLM을 사용해 프롬프트 완성하기
우리는 서로 각기 다른 모델을 사용하고, 모델마다 품질도 다르다.
보통 모델이 클수록 품질이 높아진다.
이때 레이턴시의 개념이 중요하다.
모델이 클수록 -> 계산이 많아지고 -> 사용자는 오래 기다려야한다.
그래서 우리는 이것을 결정해야한다.
① 얼마나 똑똑해야 하는가 → 모델 크기
② 얼마나 빨라야 하는가 → 지연 시간
③ 특정 목적에 더 맞춰야 하는가 → 미세 조정
이것에 따라서 우리는 모델을 조정해야한다는 것이다.
4.1.4 사용자 도메인으로 다시 변환하기
함수 호출이 있으면 LLM이 그냥 애매한 텍스트를 만드는 대신, 이 기능을 실행해줘 라는 구조화된 요청을 만들어주기 때문에 사용자 도메인으로 변환하기가 훨씬 쉬워지는 것이다.
예를 들어:
함수 호출 X
LLM → "서울에서 파리 가는 항공편을 찾아주세요..."
→ 우리가 텍스트를 해석해야 함
함수 호출 O
LLM → 항공편검색(서울, 파리, 9/25)
→ 프로그램이 바로 함수 실행 → 결과를 사용자에게 표시
4.2 순전파 확대해보기
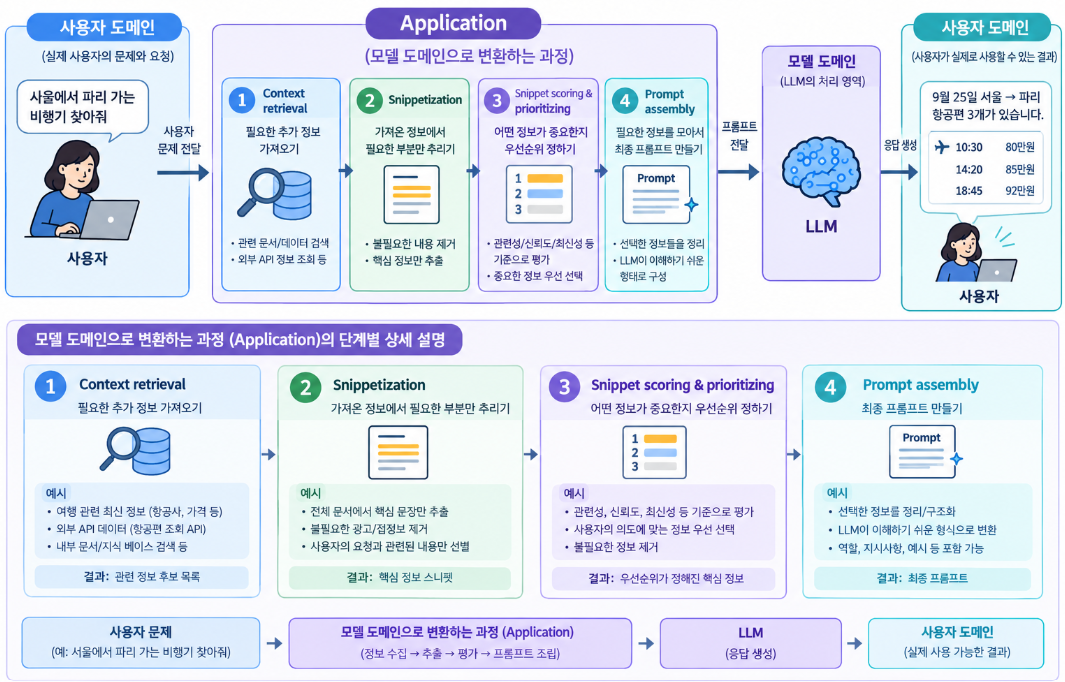
순전파는 사용자 문제를 모델 도메인으로 변환하는 루프의 일부이다.
또한 몇 가지 기초 단계로 구성된다. 여기서 총 4가지가 소개 된다.
4.2.1기본 순전파 구축하기
1.콘텍스트 검색
2.콘텍스트 스니펫화
3. 스니펫 점수 매기기 및 우선순위 지정
4. 프롬프트 구성
4.2.2 루프 복잡도 살펴보기
위 내용은, 단순한 애플리케이션이고, 사실상 실제는 애플리케이션이 복잡하다.
그 말은
애플리케이션 상태가 많아지고
외부 콘텐츠가 많아지고
추론 과정이 복잡해지고
모델 외부 환경과의 상호작용이 복잡해진다.
라는 말과 같다.
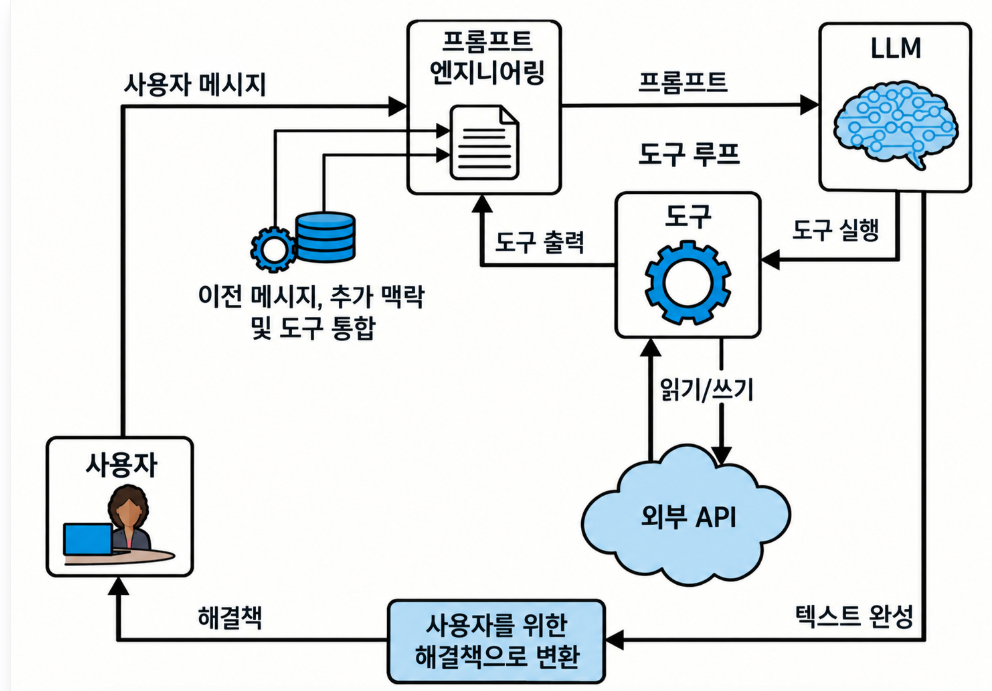
그래서 LLM 애플리케이션이 복잡해지면 무엇을 추가 하면될까? 혹은 어떤것을 하면 될까?
1. 상태 유지
이전 대화를 기억하는 것.
앱이 이전 대화를 저장하고 있어야 함.
2. 외부 맥락 → RAG(검색증강 생성, retrieval augmented generation)
LLM이 모르는 최신 정보나 개인/회사 정보를 외부에서 가져와 프롬프트에 넣는 것
3. 추론의 깊이
복잡한 문제는 LLM에게 그냥 바로 답하라고 하기보다 문제를 여러 단계로 나누어 생각하게 하는 것.
대표적인 방법이 Chain-of-Thought(생각의 사)
4. 도구 사용(Tool)
LLM이 외부 세계와 상호작용할 수 있게 하는 것.
LLM이 함수 호출을 결정 → 애플리케이션이 실제 함수를 실행 → 결과를 다시 LLM에게 전달
4.3 LLM 애플리케이션 품질 평가
LLM은 확률적으로 답을 생성하기 때문에 오류가 생길 수 있음.
-> LLM 앱은 한 번 만들고 끝이 아니라, 출시 전·후로 계속 품질을 측정하고 개선해야 한다.
4.3.1 오프라인 평가(offline evaluation)
배포 전에, LLM 애플리케이션에 새로운 아이디어를 적용해야한다.
어쩌면 온라인 평가보다 더 복잡하다. 왜냐하면 배포전이라서 사용자로 부터 good, bad 피드백을 받을수 없기 때문이다.
그래서 모의 대체 평가 방식을 정의해야한다.
평가 방법은 애플리케이션의 성격에 따라 달라진다.
① 객관적으로 측정할 수 있는 경우
코드 생성처럼 결과가 실제로 작동하는지 확인할 수 있는 경우에는 비교적 쉽게 평가할 수 있다.
예를 들어 GitHub Copilot의 코드 자동 완성이라면, 질문에 대한 답변을 딱 보고 평가 가능하다.
테스트를 통과한다면 생성된 코드가 실제로 제대로 작동할 가능성이 높다.
② 정답이 명확하지 않은 경우
일정 관리 도우미나 일반적인 채팅처럼 정답이 하나로 정해져 있지 않은 경우에는 평가가 어려워진다.
이럴 때는 LLM을 평가자(Judge)로 활용할 수 있다.
예를 들어 답변 A와 B를 보여주고 "어떤 답변이 더 좋은가?"
라고 평가하게 할 수 있다. 또는 평가 기준을 구체적으로 정할 수도 있다.
하지만, LLM의 최종 답변만 평가해서는 부족할 수 있다.
예를 들어 LLM 자체는 답변을 잘 만들더라도 잘못된 정보를 컨텍스트로 가져왔다면 최종 결과도 잘못될 수 있다.
따라서 가능하면...
컨텍스트 수집 → 프롬프트 구성 → LLM 응답 → 최종 결과
전체 과정을 평가해야 한다.
'LLM for Prompt Engineering' 카테고리의 다른 글
| 제 6장. 프롬프트 구성하기 (0) | 2026.09.26 |
|---|---|
| 제5장. 프롬프트 내용 (0) | 2026.09.22 |
| 제3장. 채팅으로 이동 (0) | 2026.09.15 |
| 2장. LLM의 이해 (0) | 2026.09.13 |
| 1장 프롬프트 엔지니어링 소개 (0) | 2026.09.08 |